퀀트 투자 입문 ⑱ — 멀티팩터, 팩터를 섞는 방법들
지난 네 편에서 밸류, 퀄리티, 저변동성, 사이즈를 하나씩 봤습니다. 매번 같은 결론이 나왔습니다. 단독으로는 어느 것도 항상 통하지 않았고, 잘 통하는 구간이 팩터마다 어긋나 있었습니다.
그렇다면 답은 뻔해 보입니다. 섞으면 됩니다. 이번 글은 그게 실제로 얼마나 도움이 되는지, 그리고 섞을 때 비중을 어떻게 정해야 하는지를 데이터로 확인합니다.
재료
Kenneth French Data Library에 공개된 Fama-French 5팩터에서 SMB(사이즈), HML(밸류), RMW(퀄리티), CMA(투자)를 쓰고, 여기에 모멘텀(MOM)을 더해 다섯 개로 갑니다. CMA는 따로 다루지 않은 팩터인데, 자산을 공격적으로 늘리는 회사보다 보수적으로 늘리는 회사가 더 나은 수익을 냈다는 관찰입니다. 모멘텀은 ④번 글에서 본 그 개념을 롱숏 포트폴리오로 만든 것입니다. 승자를 사고 패자를 파는 이 구성의 출발점이 된 Jegadeesh & Titman(1993)은 논문 읽기 ①에서 정리했습니다.
import numpy as np
import pandas as pd
from quality_factor import load as load_ff5   # quality_factor.py 를 같은 폴더에 두고 실행

MOM_URL = ("https://raw.githubusercontent.com/a91quaini/intrinsicFRP/main/"
           "data-raw/F-F_Momentum_Factor.CSV")

mom = pd.read_csv(MOM_URL)
mom.columns = [c.strip() for c in mom.columns]
mom = mom[mom["Date"].astype(str).str.len() == 6]          # 월별 블록만
mom.index = (pd.to_datetime(mom.pop("Date").astype(str), format="%Y%m")
             + pd.offsets.MonthEnd(0))
mom = (mom.iloc[:, 0].astype(float) / 100.0).rename("MOM")

r = load_ff5().join(mom, how="inner")[["SMB", "HML", "RMW", "CMA", "MOM"]].dropna()

sharpe = lambda x: x.mean() / x.std() * np.sqrt(12)
print(r.apply(sharpe).round(2).to_dict())
print("균등 혼합:", round(sharpe(r.mean(axis=1)), 2))
load_ff5는 5팩터 파일을 읽는 함수로 quality_factor.py에 있고, 전체 코드는 multifactor.py에 있습니다. 두 파일 모두 프렌치 교수 데이터의 공개 사본을 읽습니다.
5팩터 파일 사본이 2020년 7월에서 끝나서, 1963년 7월부터 2020년 7월까지 685개월입니다. 2020년 8월 이후(2022년 포함)는 이 글의 표에 없습니다. 하나씩 보면 이렇습니다.
| SMB | HML | RMW | CMA | MOM | 시장−무위험 | |
|---|---|---|---|---|---|---|
| 연복리(CAGR) | 2.02% | 2.55% | 2.81% | 2.95% | 7.08% | 5.46% |
| 연변동성 | 10.5% | 10.0% | 7.5% | 6.9% | 14.5% | 15.4% |
| 샤프 | 0.24 | 0.30 | 0.41 | 0.46 | 0.55 | 0.42 |
| MDD | -56.9% | -55.9% | -40.9% | -23.1% | -57.6% | -55.7% |
| 최장 침체 | 319개월 | 163개월 | 142개월 | 104개월 | 140개월 | 172개월 |
모멘텀이 압도적입니다. 연 7.08%에 샤프 0.55로 시장보다도 낫습니다. 반대편 끝의 SMB는 앞 글에서 본 그대로 약하고, 한 번 물리면 319개월(26년) 동안 전고점을 회복하지 못한 적이 있습니다.
왜 섞이나
상관계수를 보면 이유가 나옵니다.
| SMB | HML | RMW | CMA | MOM | |
|---|---|---|---|---|---|
| SMB | 1.00 | -0.04 | -0.34 | -0.10 | -0.05 |
| HML | -0.04 | 1.00 | 0.07 | 0.68 | -0.21 |
| RMW | -0.34 | 0.07 | 1.00 | -0.03 | 0.10 |
| CMA | -0.10 | 0.68 | -0.03 | 1.00 | -0.02 |
| MOM | -0.05 | -0.21 | 0.10 | -0.02 | 1.00 |
열 개 쌍의 평균 상관계수가 +0.01입니다. 사실상 무상관입니다. 상관관계 글에서 확인했듯 분산 효과는 상관계수가 낮을수록 커지는데, 이보다 좋은 조건을 찾기 어렵습니다.
눈에 띄는 두 개는 따로 봐야 합니다. HML과 CMA가 +0.68로 강하게 붙어 있습니다. 싼 주식과 보수적으로 투자하는 회사가 상당 부분 겹친다는 뜻입니다. 실제로 파마와 프렌치는 2015년 5팩터 모형을 제안하면서, HML이 나머지 팩터들로 거의 설명되어 중복된다고 봤습니다. 반대로 SMB와 RMW는 -0.34입니다. 사이즈 팩터 글에서 본 “소형주 바구니에 부실 기업이 많다”가 여기 숫자로 다시 나타납니다.
균등하게 섞으면
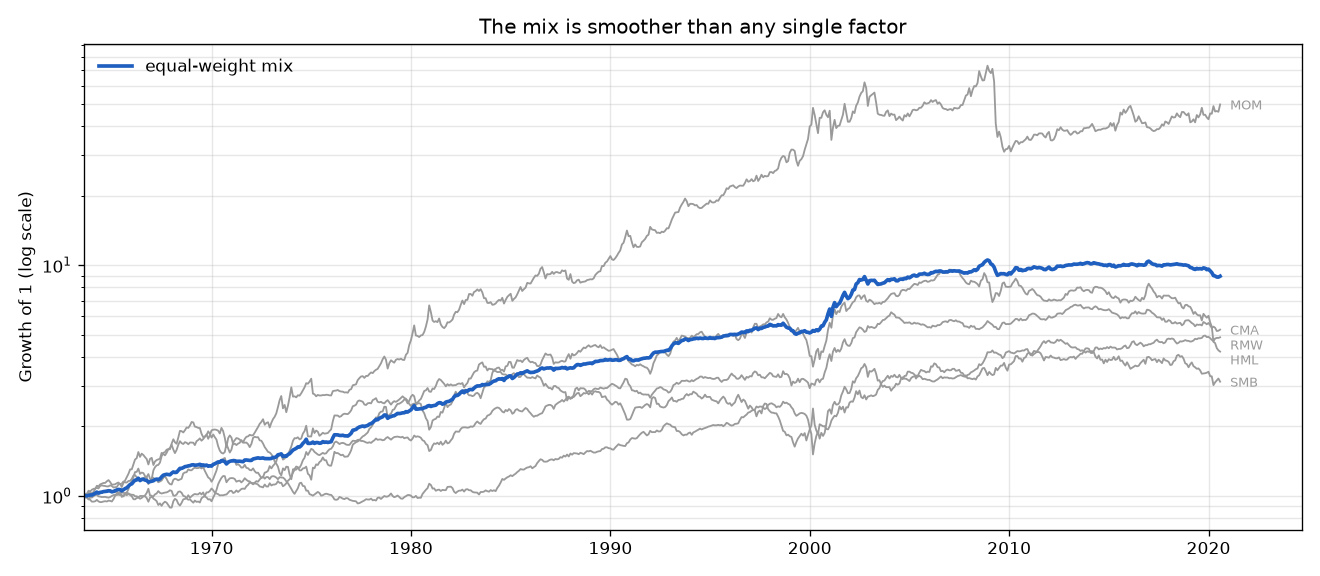
다섯 개에 20%씩 똑같이 넣어 봅니다.
| MOM 단독 (개별 최고) | 균등 혼합 | |
|---|---|---|
| 연복리(CAGR) | 7.08% | 3.92% |
| 연변동성 | 14.5% | 4.4% |
| 샤프 | 0.55 | 0.89 |
| MDD | -57.6% | -15.8% |
| t값 | 4.14 | 6.72 |
샤프비율이 0.55에서 0.89로 올랐습니다. 개별 최고보다 62% 높습니다.
주의해서 볼 것은 이 개선이 어디서 왔느냐입니다. 연복리 수익률은 오히려 7.08%에서 3.92%로 떨어졌습니다. 혼합이 수익을 만들어낸 게 아니라, 개별 팩터의 산술 평균 수익(다섯 개 평균 연 3.94%)을 그대로 가져가면서 변동성만 평균 9.9%에서 4.4%로 줄인 것입니다. 분산투자가 주는 것은 언제나 이것입니다. 수익률이 아니라 수익률 대비 더 작은 흔들림입니다.
표의 수익률은 실제로 쌓이는 연복리(CAGR)이고, 3.94%와 샤프비율은 관행대로 월수익률의 산술 평균으로 계산합니다. 변동성이 크면 복리 수익률이 산술 평균보다 낮아지고, 그 차이는 대략 분산의 절반만큼입니다(수익률 계산 글의 변동성 손실). 균등 혼합은 변동성이 4.4%로 작아서 산술 평균(3.94%)과 연복리(3.92%)가 거의 같습니다. 반대로 변동성이 큰 쪽은 차이가 벌어집니다. 시장−무위험의 연복리 5.46%가 같은 기간을 산술 평균으로 잰 저변동성 글의 시장 위험프리미엄 6.53%보다 낮은 것도 이 때문입니다.
흔들림이 줄어든 효과는 낙폭으로 보면 더 분명합니다.
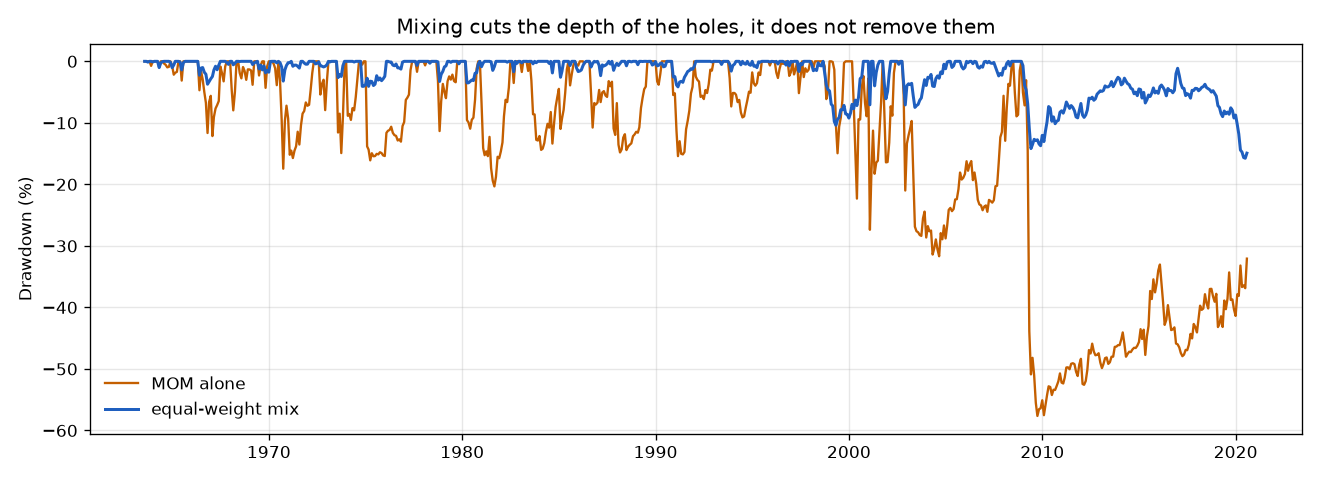
모멘텀 단독은 2009년에 -57.6%를 맞았습니다. 금융위기 직후 반등장에서 그동안 가장 많이 빠졌던 주식들이 급등하면서 모멘텀 숏 포지션이 무너진, 이른바 모멘텀 크래시입니다. 같은 시점 혼합은 -14% 정도에 그쳤습니다.
다만 그림 오른쪽 끝을 보면 혼합도 2009년 이후 데이터가 끝나는 2020년 7월까지 계속 물 밑에 있습니다. 최장 침체 140개월 — 11년 넘게 전고점을 회복하지 못했습니다. 섞으면 구덩이가 얕아지지만 없어지지는 않습니다.
비중을 잘 주면 더 좋아질까
균등 배분은 아무 생각이 없어 보입니다. 변동성이 낮은 팩터에 더 주거나, 아예 과거 데이터로 최적 비중을 계산하면 더 낫지 않을까요.
| 방식 | 연복리(CAGR) | 변동성 | 샤프 | 비중 |
|---|---|---|---|---|
| 균등 | 3.92% | 4.4% | 0.89 | 20/20/20/20/20 |
| 변동성 역가중 | 3.57% | 4.2% | 0.87 | 18/18/25/27/13 |
| 최대샤프 (전체 기간) | 3.73% | 4.0% | 0.94 | 20/2/31/31/16 |
전체 기간 데이터로 최대샤프 비중을 구하면 0.94가 나옵니다. 균등의 0.89보다 높습니다.
그런데 이 계산에는 문제가 있습니다. 1963년에 투자를 시작하는 사람은 2020년까지의 데이터를 볼 수 없습니다. 미래 참조 편향 글에서 다룬 바로 그 함정입니다. 제대로 하려면 매 시점에서 그때까지의 데이터만 써야 합니다.
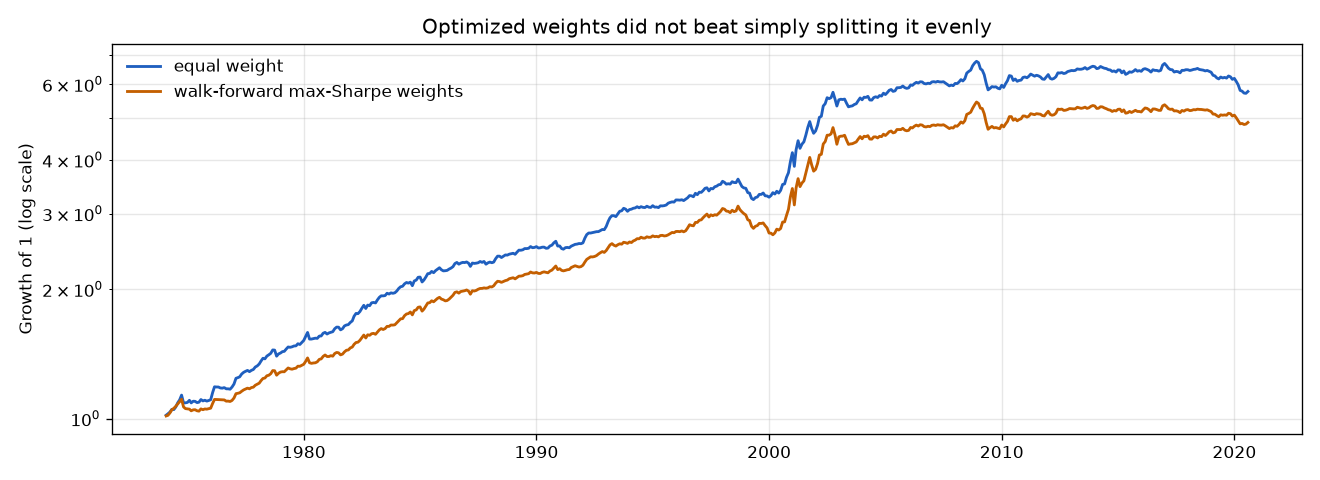
그래서 이렇게 해봤습니다. 매년 초에 그 시점까지 쌓인 데이터로 최대샤프 비중을 구하고, 그 비중으로 1년을 운용하고, 다음 해에 다시 계산합니다. 최소 10년치가 쌓인 1974년부터 시작합니다.
| 1974-01 ~ 2020-07 (559개월) | 워크포워드 최적화 | 균등 |
|---|---|---|
| 연복리(CAGR) | 3.46% | 3.83% |
| 연변동성 | 4.63% | 4.68% |
| 샤프 | 0.76 | 0.83 |
최적화가 졌습니다. 46년 내내 성실하게 다시 계산한 비중이, 아무 생각 없이 5분의 1씩 나눈 것보다 연 0.37%p 낮았습니다.
같은 구간에 “미래를 미리 본” 전체 기간 최적 비중을 적용하면 샤프 0.91이 나옵니다. 0.91과 0.76의 차이, 이것이 백테스트에서 최적화가 만들어내는 착시의 크기입니다. 과최적화 글에서 본 것과 같은 현상이 팩터 비중에서도 그대로 재현됩니다.
이유는 간단합니다. 최적화는 과거에 잘한 팩터에 비중을 몰아주는데, 팩터의 상대 성과는 10년 단위로 뒤집힙니다.
| 연대 (연복리) | SMB | HML | RMW | CMA | MOM | 균등 혼합 |
|---|---|---|---|---|---|---|
| 1970년대 | 4.2% | 7.9% | -0.7% | 6.2% | 9.4% | 5.8% |
| 1980년대 | -0.7% | 5.7% | 4.8% | 5.7% | 8.8% | 5.2% |
| 1990년대 | -2.6% | -0.5% | 2.1% | -0.3% | 13.8% | 2.7% |
| 2000년대 | 6.7% | 7.1% | 8.0% | 6.6% | -1.9% | 6.2% |
| 2010년대 | -0.7% | -2.8% | 1.4% | 0.1% | 2.7% | 0.4% |
1990년대 내내 연 13.8%를 벌어준 모멘텀이 2000년대에 연 -1.9%가 됐습니다. 1999년 말에 1990년대 데이터만 보고 비중을 짰다면 모멘텀에 크게 실었을 것이고, 그게 다음 10년 동안 발목을 잡았을 겁니다.
섞는 데에도 두 가지 방식이 있다
지금까지 한 것은 믹싱(mixing)입니다. 팩터마다 포트폴리오를 따로 만들고 그 수익률을 합치는 방식입니다. 자산운용사들이 쓰는 다른 방식은 통합 스코어링(integrated scoring)입니다. 종목마다 밸류 점수, 퀄리티 점수, 모멘텀 점수를 각각 매기고, 그걸 하나의 종합 점수로 합친 뒤 상위 종목만 삽니다.
차이는 생각보다 큽니다. 믹싱에서는 “밸류는 최상위지만 퀄리티가 바닥인 주식”이 밸류 바구니에 그대로 들어갑니다. 통합 스코어링에서는 그런 종목이 종합 점수에서 밀려 탈락하고, 대신 모든 항목에서 고루 상위권인 종목이 뽑힙니다.
어느 쪽이 나은지는 아직 정리되지 않았습니다. 통합 방식이 팩터 노출을 더 효율적으로 얻는다는 연구가 있는 반면, 믹싱이 더 투명하고 관리하기 쉽다는 반론도 있습니다. 다만 위에서 본 SMB-RMW 상관 -0.34 같은 관계를 생각하면, 통합 방식이 “작으면서 부실한 회사”를 자동으로 걸러낸다는 점은 분명한 장점입니다.
이 계산에 없는 것들
수치가 좋아 보이니 빠진 것을 짚고 넘어가야 합니다.
가장 큰 것은 이 다섯 개가 모두 롱숏 포트폴리오라는 점입니다. 주식을 빌려서 파는 쪽이 절반인데, 개인 투자자에게 공매도는 비용이 많이 들거나 아예 불가능합니다. 롱온리로 구현하면 팩터 노출이 절반 이하로 희석되고, 시장 위험이 그대로 따라 들어옵니다.
두 번째는 회전율입니다. 특히 모멘텀은 매달 순위가 바뀌므로 거래가 잦습니다. 거래 비용 글에서 확인했듯, 회전율이 높은 전략일수록 백테스트와 실전의 간극이 큽니다. 다섯 개를 겹치면 그 비용이 다섯 전략 모두에 붙습니다.
세 번째는 2010년대 성적입니다. 혼합의 연복리 수익률이 0.4%였습니다. 10년 동안 사실상 아무것도 벌지 못했습니다. 위 표의 다른 수치가 좋아 보이는 것은 1970~2000년대가 끌어올린 결과이고, 2010년대(2010~2019년)만 보면 팩터 투자 전체가 겨울이었습니다.
정리하면
- 다섯 팩터의 평균 상관계수는 +0.01입니다. 분산 효과를 얻기에 이보다 좋은 조건은 드뭅니다.
- 균등하게 섞으면 샤프가 0.55(개별 최고)에서 0.89로 오릅니다. 다만 이건 수익을 더 낸 게 아니라 변동성을 절반 이하로 줄인 결과입니다.
- 최대 낙폭은 -57.6%에서 -15.8%로 줄지만, 11년 넘게 전고점을 못 넘는 침체는 혼합에도 있습니다.
- 과거 데이터로 최적 비중을 구해 운용하면 균등 배분보다 나빴습니다(샤프 0.76 vs 0.83). 팩터의 상대 성과가 10년 단위로 뒤집히기 때문입니다.
- 이 숫자들은 롱숏·무비용 전제입니다. 실제 구현에서는 상당 부분이 깎입니다.
이번에 가장 눈에 띈 것은 모멘텀이었습니다. 단독 성과가 시장보다 좋았는데, 2009년에 한 번 -57.6%를 맞았습니다. 이렇게 강하면서 동시에 위험한 팩터를 어떻게 다룰 것인가는 그 자체로 하나의 주제입니다. 다음 글에서는 상대 모멘텀에 절대 모멘텀을 결합하는 듀얼 모멘텀을 보겠습니다.
2026-09-28 수정: 첫 표의 ‘시장’ 열이 무위험 수익률을 뺀 초과수익이라는 점을 밝혀 ‘시장−무위험’으로 고치고, 1999년 말 비중 예시가 1990년대 데이터만 보고 짠 경우라는 점을 분명히 했습니다.
참고 자료
- Jegadeesh, N., & Titman, S. (1993). Returns to Buying Winners and Selling Losers: Implications for Stock Market Efficiency. Journal of Finance, 48(1).
- Fama, E. F., & French, K. R. (2015). A five-factor asset pricing model. Journal of Financial Economics, 116(1).
이 글은 학습과 정보 공유 목적으로 작성되었으며, 특정 종목이나 상품에 대한 투자 권유가 아닙니다. 투자의 판단과 책임은 투자자 본인에게 있습니다.