퀀트 투자 입문 ⑭ — 밸류 팩터, 싼 주식은 정말 더 오르나
자산 배분 세 편을 끝내고 팩터로 넘어갑니다. 첫 주자는 가장 오래되고 가장 유명한 밸류입니다. 퀀트 투자란 무엇인가에서 소개한 네 팩터 중 첫 번째입니다.
“싼 주식을 사라”는 조언은 워런 버핏 이전부터 있었고, 1992년 파마와 프렌치가 논문으로 정리하면서 학계의 표준이 됐습니다. 저도 당연히 통하는 이야기라고 생각하고 데이터를 열었는데, 끝부분인 2007~2020년 구간을 보고 한참 멈춰 있었습니다.
HML이 무엇인가
밸류 팩터의 표준 측정치는 HML(High Minus Low)입니다. 이름 그대로입니다.
- High — 장부가/시가 비율(B/M)이 높은 주식. 회사의 장부상 가치에 비해 주가가 싼 쪽입니다.
- Low — 그 비율이 낮은 주식. 장부가 대비 비싼 쪽, 흔히 성장주라 불립니다.
- HML = 싼 주식 묶음을 사고 비싼 주식 묶음을 공매도했을 때의 수익률
시장 전체가 오르내리는 효과를 롱숏으로 상쇄했기 때문에, HML의 수익률은 “싸다는 성질 하나가 벌어다 준 초과수익”만 남습니다. 이게 팩터라는 개념의 핵심입니다. 개별 종목의 사연이 아니라 어떤 공통 성질에 값이 매겨지는지를 봅니다. HML을 이런 롱숏 포트폴리오로 처음 정의한 논문은 Fama & French(1993)이고, 논문 읽기 ②에서 따로 정리했습니다.
케네스 프렌치 교수가 이 데이터를 Kenneth French Data Library에서 1926년 7월부터 월별로 공개하고 있습니다. 아래 코드는 편의상 공개 저장소에 올라와 있는 같은 파일의 사본을 읽습니다. 이 사본이 2020년 7월에서 끝나서 이 글의 분석도 2020년 7월까지이고, 그 뒤의 구간은 담겨 있지 않습니다.
import urllib.request
import pandas as pd

URL = ("https://raw.githubusercontent.com/QuantConnect/Tutorials/master/"
       "Data/F-F_Research_Data_Factors.CSV")

raw = urllib.request.urlopen(URL).read().decode("utf-8", "ignore")
body = raw.split(",Mkt-RF,SMB,HML,RF", 1)[1]   # 헤더 뒤부터

rows = []
for line in body.splitlines():
    parts = [p.strip() for p in line.split(",")]
    if len(parts) != 5 or not parts[0].isdigit():
        continue
    if len(parts[0]) != 6:      # 월별 블록(YYYYMM) 뒤에 연간 블록(YYYY)이 이어진다
        break
    rows.append([parts[0]] + [float(x) for x in parts[1:]])

df = pd.DataFrame(rows, columns=["ym", "Mkt-RF", "SMB", "HML", "RF"])
df.index = pd.to_datetime(df.pop("ym"), format="%Y%m") + pd.offsets.MonthEnd(0)
df = df / 100.0      # 파일은 퍼센트 단위
print(df.tail())
이 파일에는 함정이 하나 있습니다. 월별 블록이 끝나면 같은 형식으로 연간 블록이 이어지는데, 둘 다 숫자 다섯 칸이라 pd.read_csv로 그냥 읽으면 연간 수익률 90여 개가 월별 데이터에 섞여 들어갑니다. 날짜 칸이 6자리(YYYYMM)인지 4자리(YYYY)인지로 끊어야 합니다. 위 코드의 if len(parts[0]) != 6: break가 그 처리입니다. 아래 표와 그림을 만드는 전체 코드는 value_factor.py에 있습니다.
94년치 결과
1926년 7월부터 2020년 7월까지 1,129개월입니다.
| HML(밸류) | 시장−무위험 | |
|---|---|---|
| 연평균 | +3.21% | +6.48% |
| 연 변동성 | 12.2% | 18.5% |
| MDD | -55.9% | -84.7% |
| t값 | 3.09 | 4.20 |
| 최장 침체 | 163개월 | 185개월 |
t값 3.09입니다. “밸류 프리미엄의 평균이 사실은 0인데 운으로 이만큼 나왔을 확률”이 0.2% 정도라는 뜻입니다. 94년이라는 긴 표본에서 통계적으로 분명하게 존재하는 현상입니다.
그런데 수익률 자체는 생각보다 소박합니다. 연 3.21%. 94년을 다 합쳐도 19.5배인데, 같은 기간 시장 초과수익은 368배입니다. 밸류는 “시장을 이기는 마법”이 아니라 “시장 위에 얇게 얹히는 추가분”이었습니다.
10년 단위로 쪼개면
평균 뒤에 숨은 것을 보려고 10년씩 끊었습니다.
| 연대 | HML 연평균 |
|---|---|
| 1930년대 | +0.38% |
| 1940년대 | +9.59% |
| 1950년대 | +3.37% |
| 1960년대 | +3.22% |
| 1970년대 | +7.85% |
| 1980년대 | +5.69% |
| 1990년대 | -0.54% |
| 2000년대 | +7.13% |
| 2010년대 | -2.85% |
아홉 개 중 두 개가 마이너스입니다. 1990년대는 IT 거품이 커지던 시기라 설명이 되고, 실제로 2000년대에 거품이 꺼지면서 +7.13%로 크게 되갚았습니다.
문제는 2010년대입니다.
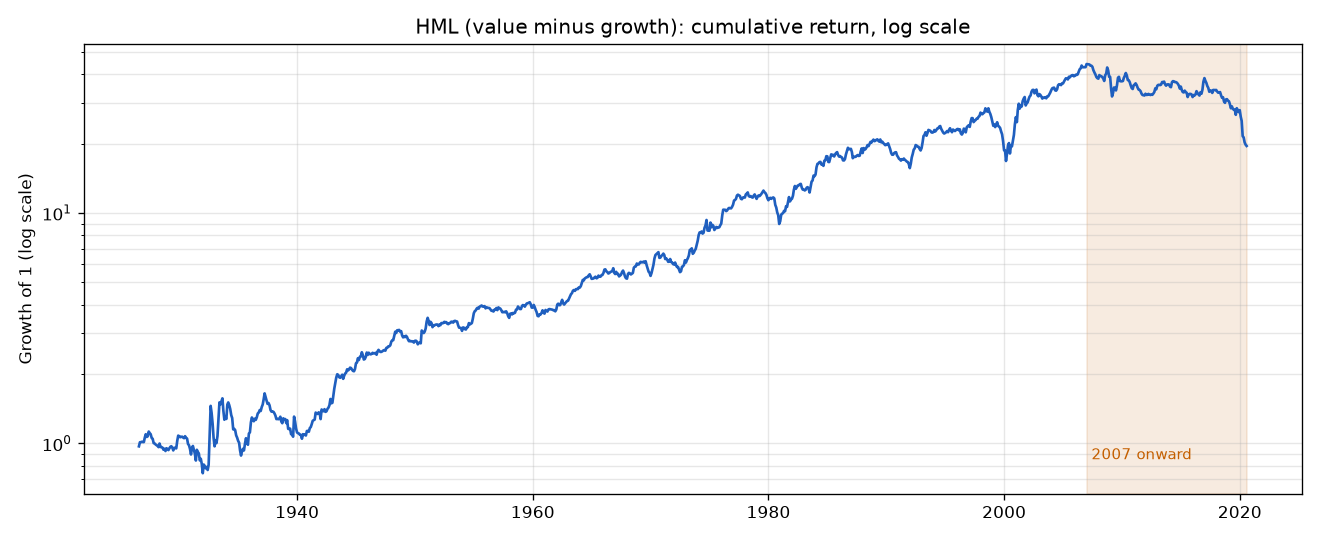
로그 척도로 그린 누적 곡선입니다. 1930년대부터 2006년까지 울퉁불퉁하지만 꾸준히 올라가다가, 오른쪽 끝에서 옆으로 눕고 아래로 꺾입니다.
2007년 이후
구간을 잘라 보면 이렇습니다.
| 구간 | 연평균 | t값 | MDD |
|---|---|---|---|
| 1926~1991 (논문 발표 전) | +4.29% | 3.17 | -43.5% |
| 1992~2006 | +7.18% | 2.60 | -40.9% |
| 2007~2020 | -5.84% | -1.99 | -55.9% |
2007년 이후 13년 반 동안 연 -5.84%입니다. t값이 -1.99로, 이번엔 마이너스 쪽으로 유의합니다. 최대 낙폭은 -55.9%이고, 2006년 12월 고점 이후 데이터가 끝나는 2020년 7월까지 한 번도 회복하지 못했습니다. 163개월, 13년 7개월입니다.
롤링 10년 수익률로 보면 얼마나 이례적인지가 분명해집니다.
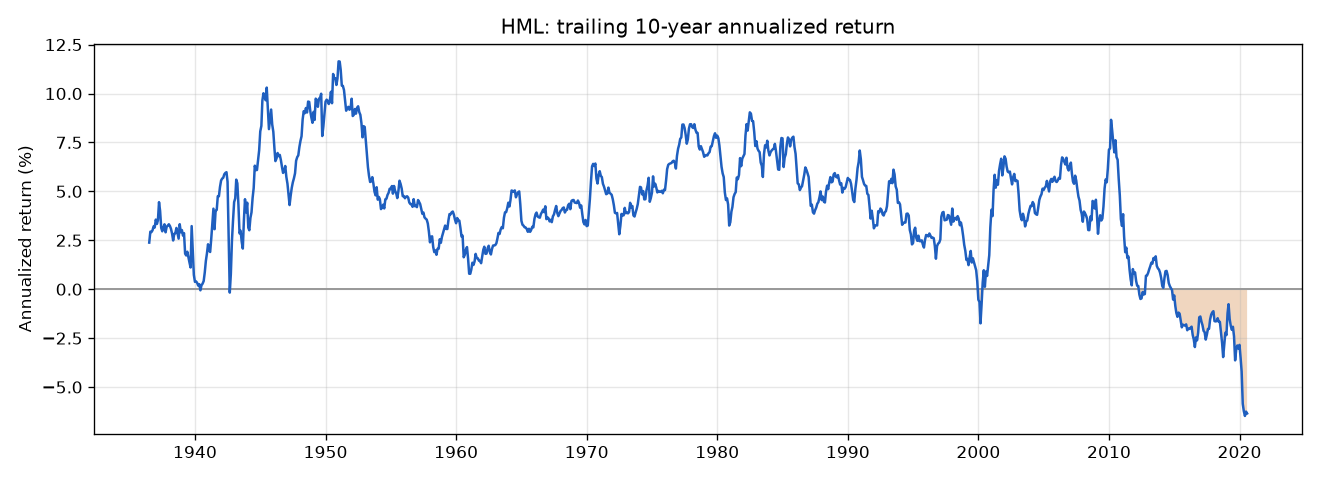
94년 동안 10년 롤링 구간이 1,010개 나오는데, 그중 마이너스는 82개로 8.1%뿐입니다. 그리고 그 82개 중 대부분이 오른쪽 끝, 2010년대 중반 이후에 몰려 있습니다. 역대 최저치도 이 구간에서 나옵니다. 2020년 5월로 끝나는 10년이 연 -6.48%입니다.
밸류 팩터를 믿고 2007년에 시작했다면, 13년 동안 한 번도 물 위로 올라오지 못한 채 손실만 쌓았다는 뜻입니다. 어떤 전략이든 13년을 버티는 사람은 거의 없습니다.
발표되면 사라지는가
팩터 이야기에 자주 따라붙는 설명이 있습니다. “논문으로 공개되면 다들 따라 해서 초과수익이 사라진다”는 것입니다. 그럴듯하지만, 위 표는 그 이야기와 딱 맞지는 않습니다.
1992년 논문 발표 후 15년(1992~2006) 동안 HML은 연 +7.18%로 오히려 발표 전(+4.29%)보다 좋았습니다. 붕괴는 발표 15년 뒤에 시작됐습니다. 발표 때문이라기엔 시차가 너무 깁니다.
그렇다고 발표 효과가 없다고 단정할 수도 없습니다. ETF와 스마트베타 상품이 본격적으로 퍼진 시점이 2000년대 후반이니, “발표”가 아니라 “대중화”에 시차를 두고 반응했다고 볼 여지도 있습니다. 저금리가 성장주 밸류에이션을 밀어올렸다는 설명, 무형자산이 늘어나면서 장부가라는 지표 자체가 낡았다는 설명도 있습니다. 어느 쪽이 맞는지 이 데이터만으로는 가릴 수 없습니다.
제가 여기서 확실하게 말할 수 있는 것은 하나뿐입니다. 94년 평균이 +3.21%이고 t값이 3이라는 사실은, 2007~2020년의 13년 반이 마이너스라는 사실과 모순되지 않습니다. 둘 다 같은 데이터에서 나온 참입니다. 긴 표본의 평균은 지금 이 순간에 무슨 일이 벌어지는지 알려주지 않습니다.
그래서 밸류를 쓸 것인가
이 글을 쓰기 전에는 “밸류는 검증된 팩터”라고 한 줄로 정리했을 것 같습니다. 지금은 이렇게 씁니다.
밸류 프리미엄은 94년 데이터에서 통계적으로 존재합니다. 다만 크기가 연 3% 남짓으로 시장 수익률의 절반도 안 되고, 10년 넘게 마이너스인 구간이 실제로 여러 번 있었으며, 데이터의 마지막 구간(2007~2020년)이 그중 최악이었습니다. 이걸 알고도 쓰겠다면 13년을 버틸 수 있는 비중으로만 담아야 한다는 것이 제가 얻은 결론입니다.
그리고 하나 더. 이 분석은 미국 데이터입니다. 한국 시장에서 같은 팩터가 어떻게 움직였는지는 별도로 확인해야 하고, 무료 데이터로 그걸 제대로 하려면 재무제표를 시점별로 맞춰야 합니다. 앞서 다룬 미래 참조 편향이 바로 거기서 튀어나옵니다. 한국 종목으로 이어 간 작업은 실전 시리즈에 있습니다. pykrx로 재무 데이터를 받는 글에서 시점 문제를 다뤘고, 종목 스크리닝과 워크포워드 검증에서 저PBR을 포함한 밸류 점수로 종목을 골라 봤습니다. 다만 그쪽 데이터는 2024년 12월부터 2026년 9월까지로 짧아서, 이 글처럼 수십 년에 걸친 팩터 성과를 확인한 것은 아닙니다.
다음 글에서는 퀄리티 팩터를 봅니다. “좋은 회사를 사면 되지 않나”라는 직관이 데이터에서는 어떻게 갈라지는지 살펴보겠습니다.
2026-09-28 수정: 2006년 12월 고점 이후 회복하지 못한 기간을 165개월(13년 9개월)에서 표의 최장 침체와 같은 163개월(13년 7개월)로 바로잡았습니다.
2026-10-22 수정: 링크한 value_factor.py가 2006년 12월 고점 이후 기간을 여전히 165개월로 출력하던 것을 본문과 같은 163개월로 고쳤고, 2007년 이후 구간 이름을 ‘최근’ 대신 데이터가 끝나는 2020년 7월까지로 표시하고 그 구간의 MDD를 2006년 12월 고점 기준(-55.9%)으로 출력하게 했습니다.
참고 자료
- Fama, E. F., & French, K. R. (1992). The Cross-Section of Expected Stock Returns. Journal of Finance, 47(2).
- Fama, E. F., & French, K. R. (1993). Common risk factors in the returns on stocks and bonds. Journal of Financial Economics, 33(1).
이 글은 학습과 정보 공유 목적으로 작성되었으며, 특정 종목이나 상품에 대한 투자 권유가 아닙니다. 투자의 판단과 책임은 투자자 본인에게 있습니다.