퀀트 실전 ③ — 워크포워드 검증, 과거의 1등은 내일의 1등이 아니다
지난 글에서 스크리닝을 만들면서 결정을 여러 번 했습니다. 지표를 무엇으로 할지, 몇 종목을 담을지, 업종 그룹 안에서 순위를 매길지. 그때마다 “이게 나아 보인다”로 넘어갔습니다.
그 결정들을 데이터로 하면 어떻게 될까요. 여러 설정을 다 돌려보고 성적이 가장 좋았던 것을 고르면 됩니다. 이게 과최적화 글에서 경고한 바로 그 일입니다. 이번에는 경고로 끝내지 않고, 실제로 그렇게 해보고 결과를 보겠습니다.
재료
실전 ①의 코드로 2024년 12월 말부터 2026년 8월 말까지 월말 스냅샷 21개와 9월 18일 스냅샷 1개, 모두 22개를 받았습니다. 구간은 21개입니다.
수익률은 스냅샷의 종가로 계산하면 안 됩니다. 액면분할이나 무상증자가 있으면 주가가 반토막 나고, 그게 가짜 손실로 잡힙니다. 그래서 전 종목 등락률을 수정주가 기준으로 따로 받았습니다.
from pykrx import stock

# adjusted=True 가 핵심. 분할·증자를 반영한 수정주가로 등락률을 계산한다.
df = stock.get_market_price_change_by_ticker("20260831", "20260918",
                                             market="ALL", adjusted=True)
여기서 한 번 틀렸습니다. 같은 함수에 delist=True 옵션이 있길래 “상장폐지 종목도 포함해서 달라”는 뜻인 줄 알고 켰습니다. 소스를 열어보니 반대였습니다. 그 옵션은 상장폐지된 종목만 돌려줍니다. 전 종목 2,870개가 나올 자리에 수십 개가 나오는 상태로 분석을 돌릴 뻔했습니다.
delist=False(기본값)로 두면 pykrx가 알아서 상장폐지 종목을 등락률 −100으로 전 종목 표에 합쳐 줍니다. 21개 구간에서 162건이 그렇게 잡혔습니다. 다만 −100은 “가치가 0이 됐다”는 가정입니다. 인수합병이나 재상장인 경우도 있으니 손실을 과하게 잡는 쪽입니다.
스냅샷은 krx_fetch_monthly.py, 구간별 등락률은 krx_fetch_returns.py로 받았습니다. KRX 데이터 파일은 이 사이트에서 다시 배포하지 않으므로, 같은 결과를 보려면 KRX 계정으로 직접 받아야 합니다.
32가지 설정
지난 글에서 고민했던 선택지들을 조합으로 펼쳤습니다.
| 축 | 선택지 |
|---|---|
| 지표 | 밸류3(이익수익률+저PBR+배당), 이익수익률만, 저PBR만, 고배당만 |
| 종목 수 | 10, 20, 30, 50 |
| 순위 기준 | 전체 한 줄 세우기 / 금융·지주와 나머지를 나눠 세우기 |
4 × 4 × 2 = 32가지입니다. 각 설정을 21개 구간에서 매달 재선정·동일비중으로 돌렸습니다. 유니버스는 지난 글과 같습니다. 보통주, 스팩 제외, 시총 1,000억 이상, BPS 있음. 시점마다 1,400종목 안팎입니다.
거래비용은 넣지 않았습니다. 매달 10~50종목을 다시 고르는 전략이라 비용을 넣으면 순위가 또 달라집니다. 이 글의 주제가 아니라 뺐는데, 빼고 본 숫자라는 점은 기억해 두셔야 합니다.
다 보고 나서 고른 1등
먼저 21개 구간을 전부 본 다음에 1등을 고릅니다. 실전에서는 불가능한 일입니다.
| 누적수익률 | |
|---|---|
| 밸류3 / 10종목 / 그룹내 순위 | +63.5% |
| 밸류3 / 20종목 / 전체 순위 | +53.6% |
| 저PBR만 / 10종목 / 그룹내 순위 | +52.2% |
| … | |
| 고배당만 / 30종목 / 그룹내 순위 | +18.0% |
| 고배당만 / 50종목 / 그룹내 순위 | +17.1% |
| 유니버스 동일비중 (기준선) | +23.8% |
32개 설정의 누적수익률 중앙값이 +40.1%이고, 25개가 유니버스를 이겼습니다. 이 기간 한국 시장에서 밸류 스크리닝이라는 접근 자체는 통했다고 볼 수 있습니다.
동시에 최고와 최저의 차이가 46.5%p입니다. 같은 아이디어인데 설정을 어떻게 잡느냐로 이만큼 갈립니다. 그러니 “우리 전략은 21개월간 63% 벌었습니다”라는 문장은, 32개를 돌려보고 1등을 골랐다는 말을 빼면 거의 거짓말입니다.
워크포워드: 미래를 보지 않고 고르기
제대로 하려면 고를 때 미래를 보지 않아야 합니다. 절차는 단순합니다.
- 처음 6개 구간은 관찰만 합니다.
- 7번째 구간을 맞을 때, 직전까지의 성적으로 1등 설정을 고릅니다.
- 그 설정으로 7번째 구간을 실제로 보유합니다.
- 8번째 구간에서는 7번째까지의 성적으로 다시 고릅니다. 반복합니다.
for i in range(warmup, len(tab)):
    hist = tab.iloc[:i][cands]      # 여기까지만 본다
    best = hist.mean().idxmax()     # 과거 1등
    realized = tab.iloc[i][best]    # 다음 구간에 실제로 받은 수익률
이렇게 하면 매 시점에서 그때 알 수 있었던 정보만 씁니다. 미래 참조 편향 글에서 다룬 원칙을 파라미터 선택에까지 적용한 것입니다.
15개 구간이 나옵니다.
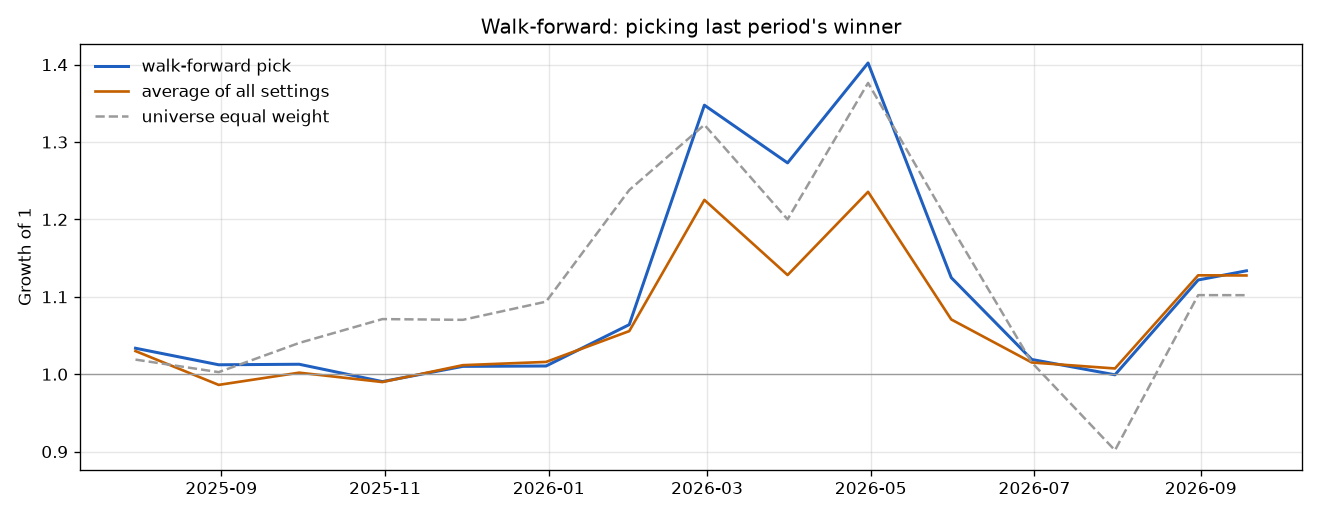
| 15개월 누적 | |
|---|---|
| 워크포워드 (매번 과거 1등을 고름) | +13.4% |
| 32개 설정을 그냥 전부 평균 | +12.8% |
| 유니버스 동일비중 | +10.2% |
과거 1등을 고르는 수고가 0.6%p 벌어줬습니다. 15개월 동안입니다.
같은 15개월에서 32개 설정을 각각 끝까지 들고 갔다면 최고는 +41.1%, 최저는 −4.8%, 중앙값은 +13.8%입니다. 워크포워드의 +13.4%는 이 분포에서 33개 중 18등입니다. 거의 한가운데입니다. 아무거나 하나 찍고 버티는 것과 다르지 않았습니다.
과거가 약속한 것과 실제로 온 것
더 선명한 숫자가 있습니다. 워크포워드가 매번 고른 설정의 과거 평균 수익률은 월 3.33%였습니다. 그 설정이 다음 달에 실제로 준 것은 월 1.33%입니다.
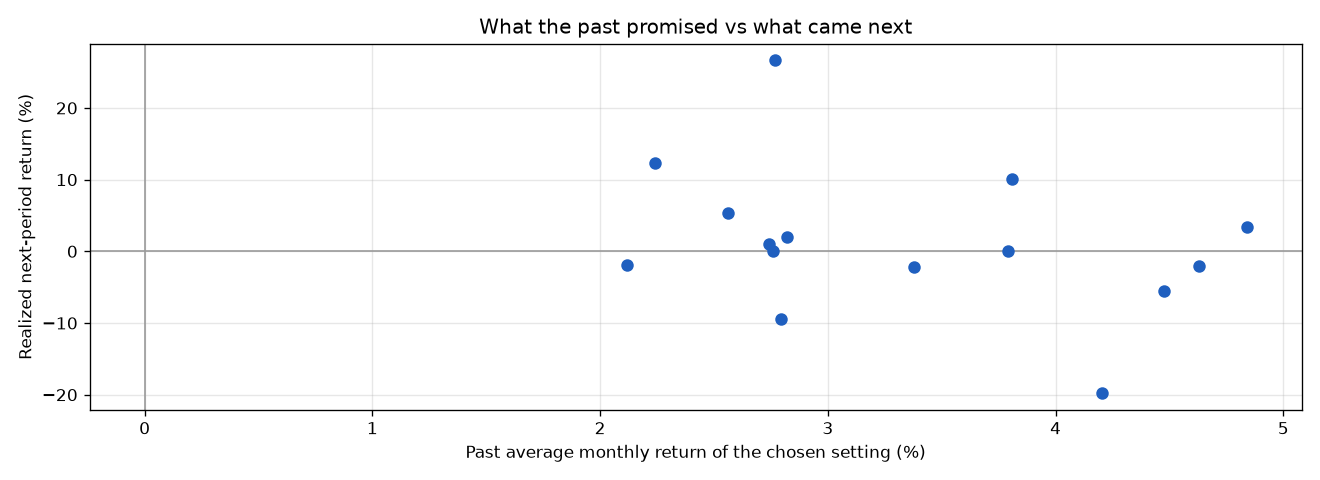
가로축이 고를 당시 그 설정의 과거 평균, 세로축이 그다음 달 실현 수익률입니다. 점들이 가로로 퍼져 있을 뿐 오른쪽 위로 올라가는 기울기가 없습니다. 과거 성적이 높았다고 해서 다음 달이 좋지는 않았습니다. 가장 오른쪽 점(과거 월평균 4.84%)의 다음 달 수익률은 +3.4%이고, 그보다 과거 성적이 낮았던 점에서 +26.7%가 나왔습니다.
순위로 봐도 같습니다. 매 시점에서 32개 설정의 과거 성적 순위와 다음 구간 성적 순위의 상관계수를 구하면 평균 −0.019, 중앙값 −0.118입니다. 양수인 구간이 15개 중 7개입니다. 동전 던지기입니다.
실제로 뽑힌 설정의 다음 구간 등수를 세어 보면 32개 중 중앙값 14등이고, 상위 절반에 든 것이 15번 중 8번입니다.
한 사례가 이걸 잘 보여줍니다. 워크포워드가 처음 고른 설정은 “고배당만 / 10종목 / 전체 순위”였습니다. 그 시점까지 월평균 4.84%로 1등이었습니다. 그런데 이 설정의 전체 기간 최종 성적은 32개 중 25등(+27.8%)입니다. 초반에 앞서 있었을 뿐입니다.
반대로 전체 1등인 “밸류3 / 10종목 / 그룹내 순위”를 워크포워드가 고른 것은 마지막 두 구간입니다. 1등인 줄 알게 됐을 때는 이미 그 수익의 대부분이 지나간 뒤였습니다.
그럼 스크리닝이 쓸모없나
아닙니다. 두 가지를 구분해야 합니다.
전략군을 고르는 것은 통했습니다. 32개 설정 중 25개가 유니버스를 이겼고, 중앙값이 +40.1%로 유니버스 +23.8%보다 한참 위입니다. “싼 주식을 사서 매달 다시 고른다”는 방향 자체는 이 기간에 작동했습니다.
그 안에서 최적 설정을 고르는 것은 통하지 않았습니다. 어떤 지표 조합인지, 10종목인지 50종목인지를 과거 성적으로 정하는 것은 정보가 아니라 잡음이었습니다.
이 구분이 실전의 결론을 바꿉니다. 파라미터를 고르려 애쓸 시간에, 애초에 파라미터에 덜 민감한 구조를 고르는 편이 낫습니다. 여러 설정을 섞어 쓰는 것도 방법입니다. 32개를 그냥 다 평균한 것이 워크포워드와 거의 같은 성적(+12.8% 대 +13.4%)을 냈다는 사실이 그 방향을 가리킵니다.
한 번 고르고 버티면
지난 글 끝에 약속한 비교입니다. 2024년 12월에 밸류3로 고른 20종목을 21개월 동안 바꾸지 않고 매달 같은 비중으로 다시 맞춰 가며 보유한 경우와, 매달 종목을 다시 뽑은 경우입니다.
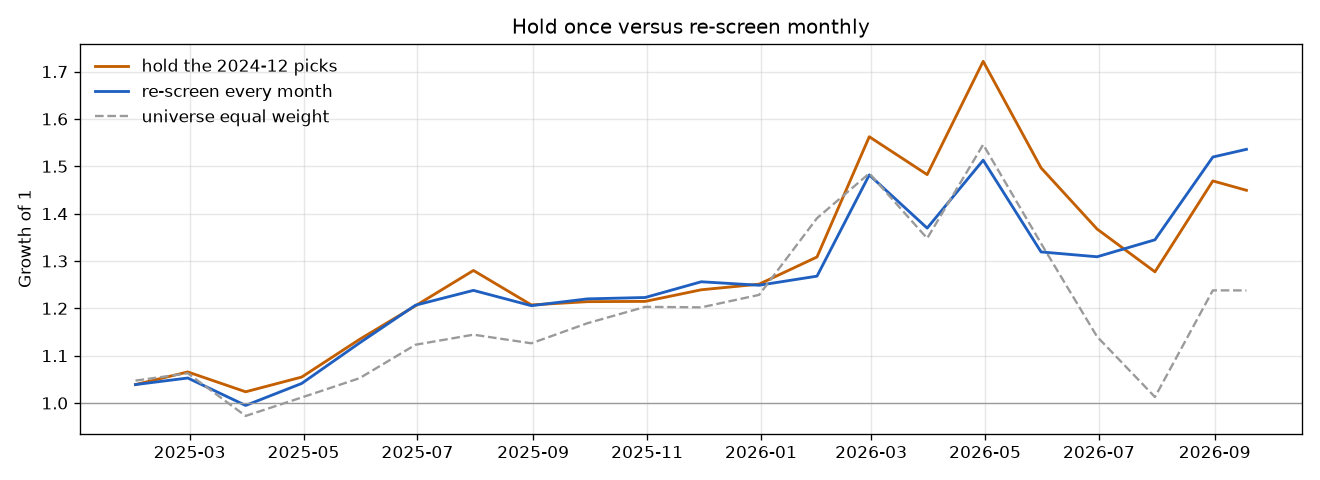
| 21개월 누적 | |
|---|---|
| 2024-12 선정 종목 고정(매달 동일비중 재조정) | +44.9% |
| 매달 재선정 | +53.6% |
| 유니버스 동일비중 | +23.8% |
매달 다시 고르는 쪽이 8.7%p 앞섰습니다. 다만 차트를 보면 2026년 6월 말까지도 고정 보유가 오히려 앞서 있었습니다. 마지막 석 달에 뒤집혔습니다. 21개월짜리 비교에서 마지막 몇 달이 순위를 정한다는 것은, 이 차이를 신뢰하기 어렵다는 뜻이기도 합니다.
처음 뽑은 20종목 중 마지막 시점에도 상위 20에 남아 있는 것은 5개입니다. 나머지 15개는 그사이 싸지 않게 됐거나, 더 싼 종목에 밀렸습니다. 매달 재선정한다는 것은 이만큼을 계속 갈아치운다는 뜻입니다. 거래비용을 뺀 숫자라는 점이 여기서 다시 걸립니다.
생존 편향은 확인했는데 나오지 않았습니다
생존 편향 글에서 사라진 종목을 빼고 보면 성적이 부풀려진다고 했습니다. 이번 데이터로 확인해 봤습니다.
상장폐지 종목을 −100%로 넣은 경우와 아예 뺀 경우의 차이는 0.0%p였습니다. 이유는 간단합니다. 21개 구간에서 유니버스 안의 상장폐지가 31건인데, 밸류3로 뽑은 20종목 안에는 한 건도 없었습니다.
시가총액 1,000억 하한이 상장폐지 후보를 미리 걸러낸 것으로 보입니다. 상장폐지되는 회사는 대개 그보다 작습니다. 확인해 보니 이 실험에서는 생존 편향이 문제가 아니었다는 결론이고, 하한을 300억으로 낮추거나 기간을 늘리면 달라질 수 있습니다. 편향이 있는지 없는지는 짐작하지 말고 매번 재어 보는 게 맞습니다.
21개월이라는 한계
이 글의 숫자는 21개월에서 나왔습니다. 짧습니다.
그 기간 유니버스 동일비중의 월평균이 +1.42%이고 플러스인 달이 21개월 중 13개월입니다. 최고 +22.2%, 최저 −14.7%. 상승장에 변동이 큰 구간이었습니다. 하락장이 길게 이어지는 국면에서 같은 결과가 나온다는 보장이 없습니다.
그래서 이 글에서 가져가실 것은 “밸류3로 10종목을 그룹내 순위로 뽑으세요”가 아닙니다. 그건 제가 32개를 다 보고 고른 1등이고, 이 글 전체가 그러지 말라는 이야기였습니다.
가져가실 것은 절차입니다. 설정을 여러 개 돌렸다면, 고르는 행위 자체도 검증 대상에 넣어야 합니다. 워크포워드는 그걸 재는 가장 간단한 도구입니다. 코드는 walkforward.py에 있고, 같은 폴더에 krx_snapshot.py와 screener.py를 함께 두어야 돌아갑니다. 스크립트 목록은 코드 페이지에 있습니다.
다음 글에서는 같은 질문을 다른 방향에서 봅니다. 백테스트 결과 하나를 놓고 “이게 운이었을 확률은 얼마인가”를 몬테카를로 시뮬레이션으로 따져 봅니다.
2026-09-28 수정: 시점별 유니버스 크기를 “1,300종목 안팎”에서 “1,400종목 안팎”으로, 고정 보유가 앞서 있던 기간을 “2026년 5월까지(마지막 넉 달에 역전)”에서 “2026년 6월 말까지(마지막 석 달에 역전)”로 바로잡고, 워크포워드 순위를 “정확히 한가운데”에서 “거의 한가운데”로 고쳤습니다.
2026-10-22 수정: “한 번 고르고 버티면” 절의 고정 보유(+44.9%)가 처음 고른 20종목을 그대로 묻어 둔 것이 아니라 같은 20종목을 매달 같은 비중으로 다시 맞춘 계산이라는 점을 본문과 표에 바로잡았습니다.
이 글은 학습과 정보 공유 목적으로 작성되었으며, 특정 종목이나 상품에 대한 투자 권유가 아닙니다. 본문의 수익률은 거래비용과 세금을 반영하지 않은 과거 데이터이며 미래 성과를 보장하지 않습니다. 투자의 판단과 책임은 투자자 본인에게 있습니다.