퀀트 투자 입문 ⑦ — 과최적화, 가장 유혹적인 함정
지난 글 마지막에 고백한 것이 있습니다. 절대 모멘텀 백테스트에서 모멘텀 기간을 12개월로 정한 것은 제가 그냥 정한 것이었습니다. 그러면 6개월, 9개월, 3개월도 다 돌려보고 제일 성과가 좋은 것을 고르면 되지 않을까요? 오늘은 그 생각이 왜 위험한지, 그리고 대신 무엇을 해야 하는지 다룹니다.
과최적화란 무엇인가
과최적화(overfitting)는 모형이 데이터의 진짜 패턴이 아니라 그 데이터에만 있는 우연까지 외워버리는 것입니다.
시험공부에 비유하면 명확합니다. 기출문제를 이해하며 푼 학생과, 기출문제의 답 순서를 통째로 외운 학생이 있습니다. 기출문제로 시험을 보면 후자가 만점입니다. 하지만 새 문제를 주면 후자는 무너집니다. 백테스트에서 파라미터를 이리저리 바꿔가며 최고 성과를 찾는 행위가 바로 답 순서를 외우는 쪽입니다.
문제는 이 행위가 너무나 자연스럽고 재미있다는 것입니다. 숫자 하나 바꿨더니 CAGR이 1%p 올라가는 경험을 하면 멈추기 어렵습니다. 그래서 과최적화는 실력이 늘수록 오히려 더 위험해지는 함정입니다.
실험: 파라미터를 전부 돌려보기
말로만 하면 와닿지 않으니 직접 돌려봅니다. 모멘텀 기간을 1개월부터 24개월까지 바꿔가며 성과를 전부 계산합니다.
import FinanceDataReader as fdr
import pandas as pd

kospi = fdr.DataReader('KS11', '2005-01-01', '2026-08-31')['Close']   # 본문 수치와 같은 기간(2026년 8월 말까지)
monthly = kospi.resample('ME').last()
returns = monthly.pct_change()

def backtest(lookback, start=None, end=None, cost=0.003):
    """절대 모멘텀 전략의 연평균 복리 수익률(CAGR)을 반환"""
    signal = (monthly.pct_change(lookback) > 0).astype(int)
    position = signal.shift(1)                 # 미래 참조 방지
    trades = position.diff().abs().fillna(0)   # 매매가 일어난 시점
    net = (position * returns - trades * cost).dropna()

    if start is not None:
        net = net[net.index >= start]
    if end is not None:
        net = net[net.index <= end]
    if len(net) == 0:
        return float('nan')

    cum = (1 + net).cumprod()
    return cum.iloc[-1] ** (12 / len(net)) - 1

scores = pd.Series({lb: backtest(lb) for lb in range(1, 25)})
print(scores.round(4))
print(f"\n최고 성과: {scores.idxmax()}개월 (CAGR {scores.max():.2%})")

scores.plot(kind='bar', figsize=(12, 4), title='Lookback vs CAGR')
돌려보면 성과가 가장 좋은 개월 수가 하나 나옵니다. 여기서 “찾았다!”고 생각하는 순간이 위험한 순간입니다.
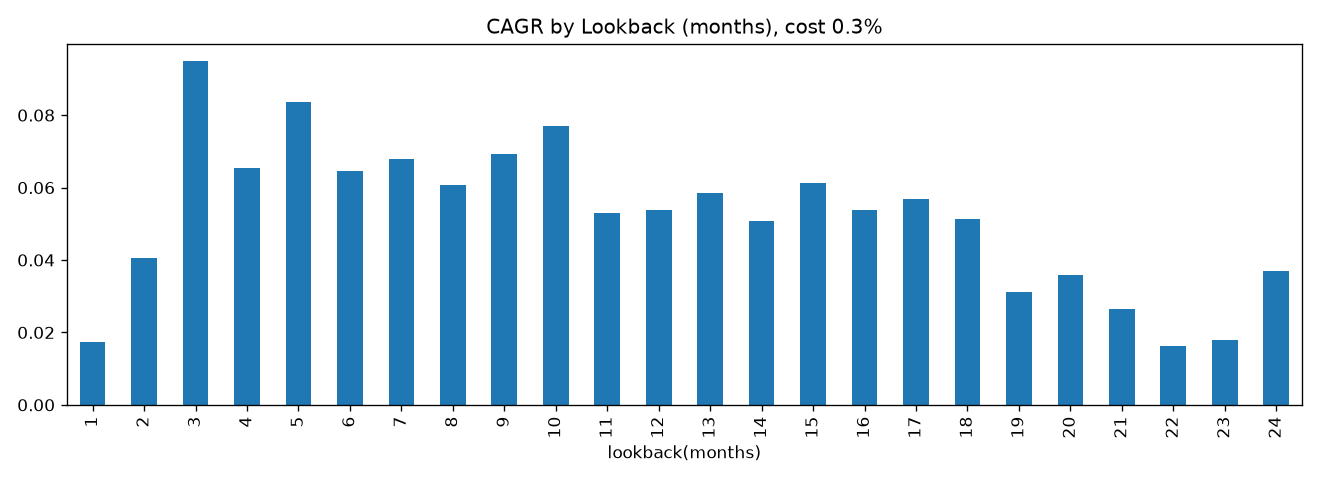
실제 코스피 데이터(2005년 1월~2026년 8월, 비용 0.3% 반영)로 돌린 결과는 이렇습니다.
| 개월 | CAGR | 개월 | CAGR | 개월 | CAGR |
|---|---|---|---|---|---|
| 1 | 1.7% | 9 | 6.9% | 17 | 5.7% |
| 2 | 4.1% | 10 | 7.7% | 18 | 5.1% |
| 3 | 9.5% | 11 | 5.3% | 19 | 3.1% |
| 4 | 6.6% | 12 | 5.4% | 20 | 3.6% |
| 5 | 8.4% | 13 | 5.8% | 21 | 2.6% |
| 6 | 6.5% | 14 | 5.1% | 22 | 1.6% |
| 7 | 6.8% | 15 | 6.1% | 23 | 1.8% |
| 8 | 6.1% | 16 | 5.4% | 24 | 3.7% |
최고는 3개월(9.5%)입니다. 첫 백테스트에서 임의로 골랐던 12개월(5.4%)보다 4%p 높습니다. 그런데 막대그래프를 보세요. 3개월 바로 양옆인 2개월은 4.1%, 4개월은 6.6%입니다. 3개월만 뾰족하게 솟아 있습니다. 이게 아래에서 말할 “절벽 위의 최고점”의 실제 모습입니다. 2개월이었으면 성과가 반토막이었을 규칙을, 미래에도 정확히 3개월이 최적일 거라 믿고 채택할 수 있을까요.
왜 최고 성과를 고르면 안 되는가
이유는 세 가지입니다.
첫째, 24번 시도했다는 사실 자체가 결과를 왜곡합니다. 동전 24개를 각각 여러 번 던져서 그중 가장 앞면이 많이 나온 동전을 고르면, 그 동전은 앞면이 잘 나오는 동전처럼 보입니다. 하지만 그건 동전의 성질이 아니라 24개 중에서 골랐다는 사실의 결과입니다. 파라미터 탐색도 똑같습니다. 여러 번 시도한 뒤 최고를 고르면, 그 최고 성과에는 실력과 운이 섞여 있고 운의 몫은 미래에 재현되지 않습니다.
둘째, 최고점은 대개 절벽 위에 있습니다. 위 막대그래프를 보세요. 최고 성과를 낸 개월 수의 양옆은 어떤가요? 옆 값들도 비슷하게 좋다면 그 구간은 믿을 만합니다. 반면 최고점만 뾰족하게 솟아 있고 한 칸 옆은 형편없다면, 그 봉우리는 데이터의 우연일 가능성이 큽니다. 미래에 그 정확한 값이 계속 최고일 이유가 없습니다.
셋째, 고르는 행위 자체가 미래 정보를 쓰는 것입니다. 2005~2026년 전체 데이터를 보고 “3개월이 최고였다”고 정하는 것은, 2005년의 나에게는 불가능한 판단입니다. 이것도 넓은 의미의 미래 참조입니다.
실제로 얼마나 무너지는지 확인하기
데이터를 반으로 갈라서, 앞부분에서 고른 최적값이 뒷부분에서도 통하는지 봅니다. 이것이 홀드아웃(hold-out) 검증의 가장 단순한 형태입니다.
MID = '2015-12-31'

# 전반부(설계 구간)에서 최적 파라미터 찾기
in_sample = pd.Series({lb: backtest(lb, end=MID) for lb in range(1, 25)})
best = in_sample.idxmax()
print(f"전반부 최적: {best}개월, CAGR {in_sample.max():.2%}")

# 그 파라미터를 후반부(검증 구간)에 그대로 적용
oos = backtest(best, start='2016-01-01')
print(f"후반부 실제 성과: {oos:.2%}")

# 비교: 전반부에서 '평범했던' 12개월은 후반부에서 어땠나
print(f"12개월 후반부 성과: {backtest(12, start='2016-01-01'):.2%}")
실제 결과는 이렇습니다.
| CAGR | |
|---|---|
| 전반부(2005~2015) 최적 파라미터 | 3개월, 7.17% |
| 그 3개월을 후반부(2016~2026)에 적용 | 11.94% |
| 비교: 12개월의 후반부 성과 | 9.46% |
| 비교: Buy & Hold 후반부 성과 | 12.39% |
여기서 정직해져야 합니다. 이 실험에서는 전반부 최적값이 후반부에서 무너지지 않았습니다. 3개월은 후반부에서도 12개월보다 나았습니다. “과최적화된 파라미터는 반드시 붕괴한다”는 교과서적 결말이 나오지 않은 겁니다.
그래서 이 결과를 어떻게 읽어야 할까요. 세 가지입니다.
첫째, 홀드아웃을 한 번 한 것은 표본이 하나인 실험입니다. 갈라지는 지점을 2013년이나 2018년으로 바꾸면 결론이 달라질 수 있습니다. 한 번의 검증 통과가 “이 파라미터는 진짜다”의 증명이 되지는 않습니다. 검증 시점을 매달 옮겨 가며 그때까지의 성적으로 다시 고르는 방식(워크포워드)은 워크포워드 검증 글에서 밸류 스크리닝 설정 32가지로 해 봤습니다.
둘째, 살아남았다고 해서 뾰족한 봉우리가 고원이 되는 것은 아닙니다. 3개월은 여전히 양옆이 절벽인 값이고, 모멘텀 글에서 말한 3~12개월 구간의 가장 짧은 끝이라 12개월보다 신호가 더 자주 바뀝니다(전체 기간 매매 54회 대 37회). 후반부에 운이 따랐을 가능성을 배제할 수 없습니다.
셋째, 그리고 가장 중요한 것. 전반부에서 고른 3개월(11.94%)도, 처음에 임의로 정한 12개월(9.46%)도 후반부의 Buy & Hold(12.39%)는 이기지 못했습니다. 1~24개월 가운데 후반부에 Buy & Hold를 넘은 것은 10개월(13.22%) 하나뿐인데, 10개월은 전반부 성과가 6위(2.58%)여서 2015년 말 시점에는 고를 이유가 없던 값입니다. 결과를 다 본 뒤 “10개월이었으면 이겼다”고 말하는 것이 바로 이 글이 경계하는 과최적화입니다. 파라미터 탐색에 시간을 쓰기 전에 “이 전략이 비교 대상보다 나은가”를 먼저 물어야 한다는 것을 이 숫자가 보여줍니다.
이 실험은 반드시 한 번 직접 해보시기를 권합니다. 남의 백테스트를 볼 때의 태도가 달라집니다. 위의 파라미터 표와 홀드아웃 결과는 run_series_backtests.py로 다시 계산할 수 있습니다.
과최적화를 피하는 다섯 가지 습관
- 가설을 먼저, 검증을 나중에 — 데이터를 보기 전에 “왜 이게 통할 것인가”를 문장으로 적습니다. 모멘텀은 정보의 느린 반영 때문에 통한다는 설명이 먼저 있고, 검증은 그다음입니다. 설명 없이 데이터에서 찾아낸 규칙은 대부분 우연입니다.
- 파라미터 개수를 줄입니다 — 조정할 수 있는 손잡이가 많을수록 과최적화는 쉬워집니다. 손잡이 하나짜리 단순한 전략이 손잡이 다섯 개짜리보다 대개 더 오래 살아남습니다.
- 최고점이 아니라 고원을 고릅니다 — 인접한 파라미터들도 함께 괜찮은 넓은 구간의 가운데 값을 씁니다. 뾰족한 봉우리는 피합니다.
- 검증 데이터를 아껴 씁니다 — 홀드아웃 구간을 정했으면 거기서 성과를 확인한 뒤 다시 전반부로 돌아가 규칙을 고치면 안 됩니다. 그 순간 홀드아웃은 오염되어 더 이상 검증 구간이 아닙니다.
- 시도 횟수를 세어 둡니다 — 몇 개의 조합을 시험했는지 기록합니다. 100개를 돌려서 찾은 최고 성과는, 3개를 돌려서 찾은 최고 성과보다 훨씬 더 의심해야 합니다.
정리
- 과최적화는 데이터의 우연까지 외워버리는 것이고, 파라미터를 뒤져 최고를 고르는 순간 시작된다.
- 여러 번 시도한 뒤의 최고 성과에는 운이 섞여 있으며, 그 운은 미래에 재현되지 않는다.
- 최고점이 뾰족한지 고원인지 확인하고, 데이터를 갈라 홀드아웃 검증을 해본다.
- 가설을 먼저 세우고, 파라미터를 줄이고, 시도 횟수를 기록하는 습관이 최선의 방어다.
다음 글에서는 지금까지 CAGR과 MDD만으로 봐 온 성과 평가를 확장합니다. 변동성, 샤프비율, 칼마비율이 각각 무엇을 재는 지표이고, 어떤 상황에서 어떤 지표가 오해를 부르는지 정리하겠습니다.
2026-09-28 수정: 전체 기간 최고 파라미터를 표와 다른 “17개월”로 적었던 문장을 표대로 3개월로 바로잡고, 동전 비유를 “24개 중에서 골랐다”는 사실이 결과를 왜곡한다는 뜻이 드러나게 고쳤습니다.
2026-10-22 수정: 홀드아웃 후반부에 어떤 개월 수도 Buy & Hold를 이기지 못했다고 쓴 문장과 요약문을 바로잡고(전반부 6위였던 10개월은 이겼습니다), 2015년 12월이 전반부와 후반부에 겹치던 경계를 2016년 1월부터로 고쳐 후반부 수치(3개월 11.94%, 12개월 9.46%)를 다시 계산했으며, 코드에 데이터 종료일(2026년 8월 말)을 넣고 3개월 모멘텀에 대한 근거 없는 서술을 실제 매매 횟수로 바꿨습니다.
이 글은 학습과 정보 공유 목적으로 작성되었으며, 특정 종목이나 상품에 대한 투자 권유가 아닙니다. 투자의 판단과 책임은 투자자 본인에게 있습니다.