퀀트 실전 ② — 종목 스크리닝 시스템 만들기
지난 글에서 전 종목 재무 스냅샷을 만드는 코드를 썼습니다. 이번 글은 그 스냅샷으로 종목을 줄 세우는 스크리닝을 만듭니다. 본문의 숫자는 2024년 12월 13일 기준 KRX 전 종목 스냅샷(2,857종목, pykrx와 같은 열 구조)에서 나왔습니다. 이 파일은 KRX가 배포한 원본이 아니라, 제3자가 GitHub 공개 저장소(Jehoshaphat-kr/tdatlib)에 올려 둔 비공식 사본입니다. 코드는 screener.py에 있고, 같은 폴더에 krx_snapshot.py를 함께 두어야 돌아갑니다. --file 옵션으로 직접 받은 CSV를 넣으면 같은 분석이 됩니다.
(2026-09-21 업데이트: 지난 글의 코드로 2026년 9월 18일 KRX 스냅샷을 직접 받아 같은 분석을 다시 돌렸고, 그 결과를 글 뒤쪽 “2026년 9월 스냅샷으로 다시 돌리면” 절에 붙였습니다. 본문의 2024년 12월 숫자는 그대로 두었습니다. 다음 글의 출발점이기 때문입니다.)
스크리닝은 두 단계입니다. 유니버스를 정하고(어떤 종목을 후보로 볼지), 줄을 세웁니다(후보 중 무엇을 위에 둘지). 이 둘을 섞으면 나중에 무엇이 결과를 만들었는지 알 수 없게 됩니다.
유니버스 좁히기
| 단계 | 남는 종목 |
|---|---|
| 전체 | 2,857 |
| 우선주 제외 (종목코드 끝자리가 0이 아닌 것) | 2,741 |
| 스팩 제외 | 2,641 |
| 시가총액 1,000억 이상 | 1,372 |
| BPS가 없는 종목 제외 | 1,322 |
한국 종목코드는 여섯 자리이고 관례상 보통주는 끝자리가 0, 우선주는 5·7·9 같은 홀수입니다. 이걸로 116개를 걸러냅니다. (2026년 스냅샷에는 00104K, 37550L처럼 영문이 섞인 새 형식 코드가 80개 있는데, 우선주는 끝자리가 K·L이라 “끝자리 0” 규칙이 그대로 통합니다.) 스팩은 이름에 “스팩”이 들어가니 문자열로 거릅니다.
시가총액 하한 1,000억은 임의의 숫자입니다. 이 숫자가 결과를 얼마나 바꾸는지는 글 끝에서 봅니다.
적자 종목(375개)은 남깁니다. 걸러내는 대신 순위 맨 아래로 보내는 쪽이 낫습니다. 이유는 조금 뒤에 나옵니다.
지표 하나로 줄 세우면
가장 단순한 스크리닝은 PBR 낮은 순입니다.
| 종목명 | PBR | PER | 배당수익률 | 시총(억) |
|---|---|---|---|---|
| 롯데하이마트 | 0.13 | 적자 | 4.16% | 1,721 |
| 태광산업 | 0.13 | 적자 | 0.29% | 6,636 |
| 티케이케미칼 | 0.13 | 적자 | 0.00% | 1,236 |
| 동국홀딩스 | 0.14 | 1.67 | 8.00% | 2,385 |
| 계룡건설산업 | 0.15 | 2.46 | 3.05% | 1,173 |
| 한화생명 | 0.15 | 2.75 | 5.73% | 22,669 |
| 현대제철 | 0.15 | 6.29 | 4.54% | 29,291 |
| 이마트 | 0.15 | 적자 | 3.11% | 17,924 |
상위 20개 중 9개가 적자이고 6개가 금융·지주회사입니다. PBR이 0.13이라는 것은 회사가 장부에 적어둔 순자산의 13% 가격에 거래된다는 뜻입니다. 싸 보이지만, 시장이 그 장부가를 믿지 않는다는 뜻이기도 합니다. 이걸 밸류 트랩이라고 부릅니다. 밸류 팩터 글에서 본 HML은 이런 종목을 수백 개 묶어서 평균을 내기 때문에 통했던 것이고, 상위 20개만 뽑으면 이야기가 다릅니다. HML이 B/M 상위 30%와 하위 30% 포트폴리오의 수익률 차이로 만들어지는 방식은 Fama & French(1993) 논문 읽기에 정리해 두었습니다.
세 지표를 순위로 합치기
한 지표의 극단값을 피하려면 여러 지표를 합칩니다. 값을 그대로 더하면 단위가 달라 안 되니 순위로 바꿔서 평균합니다. 이익수익률(EPS/주가, 클수록 쌈), PBR의 역수, 배당수익률 셋입니다.
def rank_score(u, cols):
    """여러 지표의 순위를 평균한 점수 (0~1, 클수록 좋음). 결측은 최하위로 둔다."""
    ranks = u[cols].rank(pct=True, na_option="top")
    return ranks.mean(axis=1)

u["_pbr_inv"] = 1 / u["PBR"]              # 낮을수록 좋은 PBR 을 뒤집는다
u["점수"] = rank_score(u, ["이익수익률", "_pbr_inv", "DIV"])
여기서 한 번 틀렸습니다. 처음에 na_option="bottom"으로 썼더니 이런 표가 나왔습니다.
| 종목명 | 점수 | 이익수익률 | PBR | 배당수익률 |
|---|---|---|---|---|
| 한국토지신탁 | 0.934 | 결측 | 0.22 | 6.80% |
| 롯데지주 | 0.933 | 결측 | 0.23 | 6.94% |
| 일성아이에스 | 0.930 | 결측 | 0.28 | 9.40% |
| 롯데케미칼 | 0.926 | 결측 | 0.17 | 5.56% |
적자 기업이 맨 위에 왔습니다. pandas의 rank는 큰 값에 큰 순위를 주고, na_option="bottom"은 결측을 순위의 끝, 즉 가장 큰 순위에 둡니다. 제 점수 체계에서 큰 순위는 좋은 것이니 결측이 만점 근처를 받은 겁니다. 결측을 나쁘게 취급하려면 "top"이어야 합니다. 이름이 반대로 읽힙니다.
이게 적자 종목을 걸러내지 않고 남겨둔 이유이기도 합니다. 걸러냈으면 이 버그를 못 봤을 것이고, 다른 결측이 같은 방식으로 위로 올라오는 것도 못 봤을 겁니다.
고치고 나면 이렇습니다.
| 종목명 | 점수 | 이익수익률 | PBR | 배당수익률 | 시총(억) |
|---|---|---|---|---|---|
| 동국홀딩스 | 0.994 | 0.600 | 0.14 | 8.00% | 2,385 |
| SK디앤디 | 0.984 | 0.553 | 0.24 | 10.60% | 1,411 |
| E1 | 0.972 | 0.509 | 0.26 | 7.10% | 4,974 |
| 동국제강 | 0.971 | 0.342 | 0.24 | 8.33% | 4,127 |
| KPX홀딩스 | 0.970 | 0.396 | 0.23 | 6.49% | 2,290 |
| 한화생명 | 0.968 | 0.364 | 0.15 | 5.73% | 22,669 |
| 휴스틸 | 0.962 | 0.331 | 0.22 | 6.44% | 2,180 |
| 세아제강 | 0.952 | 0.564 | 0.34 | 6.69% | 3,392 |
| 동양생명 | 0.952 | 0.313 | 0.30 | 7.22% | 8,955 |
| 한국자산신탁 | 0.947 | 0.360 | 0.35 | 7.48% | 3,626 |
적자는 사라졌고, 이익수익률 0.6이면 PER 1.7이라는 뜻입니다. 대신 20개 중 8개가 금융·지주회사입니다. 지주, 홀딩스, 생명, 손해보험, 금융지주. 이름만 봐도 알 수 있습니다.
왜 금융과 지주회사로 채워지나
이유는 PBR의 분포가 업종마다 다르기 때문입니다.
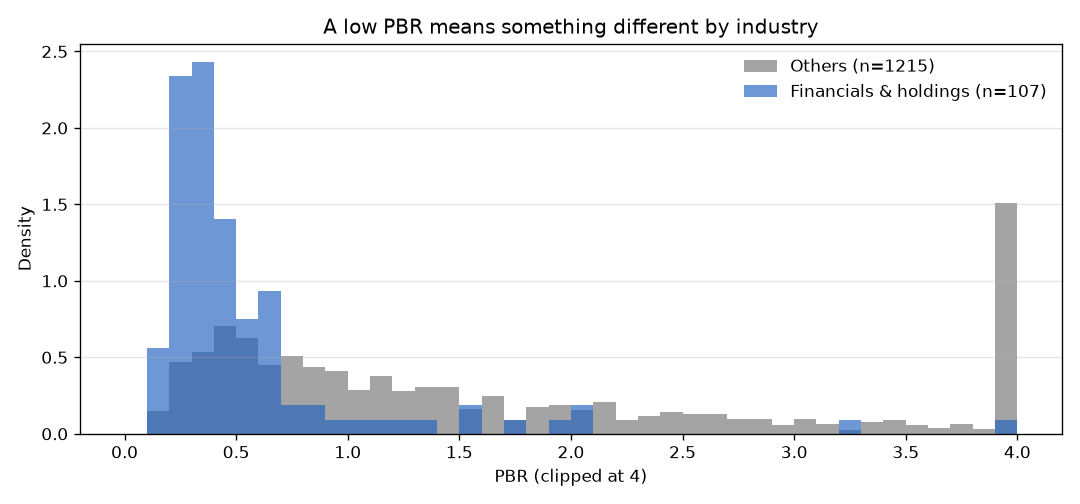
| 종목 수 | PBR 하위 10% | 25% | 중앙값 | 75% | |
|---|---|---|---|---|---|
| 금융·지주 | 107 | 0.23 | 0.29 | 0.38 | 0.61 |
| 나머지 | 1,215 | 0.37 | 0.61 | 1.21 | 2.56 |
금융·지주의 PBR 중앙값이 0.38입니다. 나머지의 하위 10%가 0.37입니다. 금융에서 보통인 PBR이 제조업에서는 최하위 10%입니다. 전 종목을 한 줄로 세우면 금융·지주가 앞쪽에 몰리는 게 당연합니다.
이건 금융주가 싸다는 뜻이 아닙니다. 은행과 보험은 자산 대부분이 장부가 그대로 평가되는 금융자산이라 PBR이 1 근처면 이미 비싼 편이고, 지주회사는 자산 대부분이 자회사 지분이라 구조적으로 할인됩니다. 같은 숫자가 업종에 따라 다른 뜻입니다.
그룹 안에서 줄 세우기
해법은 순위를 그룹 안에서 매기는 것입니다. 금융·지주는 금융·지주끼리, 나머지는 나머지끼리.
FIN_WORDS = "지주|홀딩스|금융|은행|증권|보험|캐피탈|카드|생명|화재|인베스트"

def is_financial(names):
    """종목명에 금융·지주 관련 단어가 들어 있으면 True. 업종 분류가 아니라 이름 기준이다."""
    return names.str.contains(FIN_WORDS, na=False)

cols = ["이익수익률", "_pbr_inv", "DIV"]
u["그룹"] = np.where(is_financial(u["종목명"]), "금융·지주", "일반")
u["점수_그룹내"] = u.groupby("그룹")[cols].rank(pct=True, na_option="top").mean(axis=1)
| 종목명 | 그룹 | 점수 | 이익수익률 | PBR | 배당수익률 |
|---|---|---|---|---|---|
| SK디앤디 | 일반 | 0.988 | 0.553 | 0.24 | 10.60% |
| 동국홀딩스 | 금융·지주 | 0.988 | 0.600 | 0.14 | 8.00% |
| E1 | 일반 | 0.977 | 0.509 | 0.26 | 7.10% |
| 동국제강 | 일반 | 0.976 | 0.342 | 0.24 | 8.33% |
| 휴스틸 | 일반 | 0.968 | 0.331 | 0.22 | 6.44% |
| 세아제강 | 일반 | 0.963 | 0.564 | 0.34 | 6.69% |
| 한국자산신탁 | 일반 | 0.958 | 0.360 | 0.35 | 7.48% |
| GS | 일반 | 0.956 | 0.339 | 0.29 | 6.17% |
금융·지주가 8개에서 1개로 줄고 철강, 가스, 유통, 건설이 올라옵니다. 다만 그룹을 이름의 문자열로 나눈 것이라 거칩니다. “GS”는 지주회사인데 이름에 “지주”가 없어서 일반으로 갔습니다. 손해보험사인 현대해상도 이름에 “보험”이나 “화재”가 없어 일반으로 갔고, 부동산신탁회사인 한국자산신탁도 일반에 들어 있습니다. 이 둘을 금융으로 치면 앞의 순위 평균 상위 20개 중 금융·지주는 8개가 아니라 10개(GS까지 넣으면 11개)입니다. 이 둘을 금융·지주 그룹으로 옮겨 다시 돌려도 그룹 안 순위 상위 20개 중 금융·지주는 1개로 같습니다. 제대로 하려면 업종 분류 데이터를 붙여야 하는데, 이 시리즈에서는 거기까지 하지 못했으므로 이 점을 한계로 남겨 둡니다.
그룹별로 몇 개씩 넣을지는 별도 결정입니다. 그룹 안 순위로 바꾸면 편중은 사라지지만, 금융을 0개 넣을지 5개 넣을지는 스크리닝이 정해주지 않습니다.
시총 하한이 결과를 얼마나 바꾸나
앞에서 임의로 정한 1,000억을 흔들어 봅니다.
| 시총 하한 | 후보 | 상위 20 중앙 시총 | 금융·지주 |
|---|---|---|---|
| 300억 | 2,239 | 3,876억 | 8개 |
| 1,000억 | 1,322 | 4,547억 | 8개 |
| 5,000억 | 387 | 11,960억 | 11개 |
| 2조 | 145 | 40,600억 | 10개 |
하한을 올릴수록 금융·지주 비중이 커집니다. 큰 회사 중에 싼 회사는 대부분 금융이기 때문입니다. 소형주까지 열면 제조업 밸류주가 섞여 들어옵니다. 사이즈 팩터 글에서 소형주 바구니에 부실 기업이 많다고 했는데, 밸류 스크리닝에서는 반대로 소형주를 열어야 금융 편중이 풀리는 면이 있습니다. 어느 쪽이 맞는지는 이 표가 아니라 백테스트가 답할 문제입니다.
2026년 9월 스냅샷으로 다시 돌리면
(2026-09-21 업데이트) 위 분석은 2024년 12월 13일 비공식 사본 한 장으로 한 것입니다. 같은 분석을 지난 글의 코드로 직접 받은 2026년 9월 18일 KRX 스냅샷으로 다시 돌렸습니다. 받아 둔 원본 파일을 python screener.py --file snapshot_20260918.csv.gz처럼 넘기면 됩니다.
| 2024-12-13 | 2026-09-18 | |
|---|---|---|
| 전체 종목 | 2,857 | 2,714 |
| 유니버스 (보통주, 스팩 제외, 시총 1,000억 이상, BPS 있음) | 1,322 | 1,305 |
| 그중 적자 | 375 | 366 |
| PBR 상위 20 중 적자 / 금융·지주 | 9개 / 6개 | 6개 / 1개 |
| 순위 평균 상위 20 중 금융·지주 | 8개 | 4개 |
| 그룹 내 순위 상위 20 중 금융·지주 | 1개 | 0개 |
| 금융·지주 PBR 중앙값 | 0.38 | 0.48 |
| 나머지 PBR 중앙값 | 1.21 | 1.31 |
| 나머지 PBR 하위 10% | 0.37 | 0.37 |
유니버스 크기와 적자 비율은 거의 같습니다. 달라진 것은 금융·지주 편중의 정도입니다. PBR 하나로 세웠을 때 6개였던 금융·지주가 1개로, 순위 평균에서 8개였던 것이 4개로 줄었습니다.
이유는 표의 아래쪽에 있습니다. 금융·지주의 PBR 중앙값이 0.38에서 0.48로 올라간 반면, 나머지 종목의 하위 10%는 0.37 그대로입니다. 2024년 말에는 “금융에서 보통인 PBR”이 “제조업 하위 10%”와 거의 같은 숫자였는데, 2026년 9월에는 금융의 보통이 제조업 하위 10%보다 확실히 위에 있습니다. 그 사이 은행·보험·지주회사 주가가 장부가 대비 재평가된 것이고, 그만큼 전 종목 한 줄 세우기의 앞자리에서 밀려났습니다.
순위 평균 상위 10개(2026-09-18)입니다.
| 종목명 | 점수 | 이익수익률 | PBR | 배당수익률 | 시총(억) |
|---|---|---|---|---|---|
| HS화성 | 0.965 | 0.264 | 0.24 | 6.80% | 1,120 |
| 한국캐피탈 | 0.952 | 0.409 | 0.29 | 5.66% | 2,231 |
| 우리손에프앤지 | 0.949 | 0.223 | 0.32 | 9.74% | 1,066 |
| 지역난방공사 | 0.948 | 0.375 | 0.38 | 8.22% | 8,672 |
| 무학 | 0.946 | 0.250 | 0.33 | 7.45% | 2,166 |
| KG스틸 | 0.940 | 0.243 | 0.27 | 5.23% | 5,741 |
| 화승인더 | 0.932 | 0.172 | 0.33 | 8.96% | 1,272 |
| 광주신세계 | 0.925 | 0.166 | 0.31 | 6.84% | 2,677 |
| KPX케미칼 | 0.924 | 0.190 | 0.35 | 6.70% | 2,322 |
| HDC현대EP | 0.924 | 0.330 | 0.28 | 4.13% | 1,235 |
2024년 말 상위 10개(동국홀딩스, SK디앤디, E1, 동국제강, KPX홀딩스, 한화생명…)와 겹치는 이름이 상위 10개 안에는 없습니다. 20개까지 넓혀야 E1, KPX홀딩스, 한국자산신탁이 다시 보입니다. 이익수익률 0.6(PER 1.7)짜리 종목은 사라졌고, 상위권의 이익수익률이 0.17~0.41(PER 2.5~6) 대로 내려왔습니다. 2024년 말의 극단적인 저PER은 상당수가 일회성 이익이었을 가능성이 크고, 그 이익이 EPS에서 빠지면서 순위에서도 빠진 것으로 보입니다. 이건 스크리닝이 한 시점의 스냅샷이라는 사실을 그대로 보여줍니다. 오늘 싼 종목 목록과 2년 전 싼 종목 목록은 다른 목록입니다.
시총 하한 실험은 방향이 같습니다.
| 시총 하한 | 후보 (2026-09) | 금융·지주 (2024-12) | 금융·지주 (2026-09) |
|---|---|---|---|
| 300억 | 2,147 | 8개 | 1개 |
| 1,000억 | 1,305 | 8개 | 4개 |
| 5,000억 | 462 | 11개 | 8개 |
| 2조 | 213 | 10개 | 10개 |
하한을 올릴수록 금융·지주가 늘어나는 패턴은 그대로입니다. 대형주 중에 싼 주식은 여전히 금융이고, 소형주를 열어야 제조업 밸류주가 들어옵니다. 다만 소형주 쪽에서는 금융 편중이 2024년보다 훨씬 약해졌습니다.
지난 글 정정
지난 글에 “이익수익률은 적자에서 음수로 자연스럽게 이어진다”고 썼습니다. 틀렸습니다. 이 파일에서 확인해 보니 KRX는 적자 종목의 EPS 자체를 0으로 줍니다. 1,016개 종목이 EPS 0이고 음수는 하나도 없습니다. 손실이 얼마인지는 이 데이터로 알 수 없고, 이익수익률은 음수가 아니라 결측이 됩니다. 지난 글의 해당 문장을 고쳤습니다.
정리하면
- 스크리닝은 유니버스와 순위를 분리해서 짭니다. 무엇이 결과를 만들었는지 추적하기 위해서입니다.
- PBR 하나로 세우면 상위 20개 중 9개가 적자, 6개가 금융·지주입니다. 세 지표를 순위 평균하면 적자는 빠지고 금융·지주가 8개로 늘어납니다.
- 이유는 금융·지주의 PBR 중앙값(0.38)이 나머지 하위 10%(0.37)와 거의 같기 때문입니다. 순위를 그룹 안에서 매기면 8개가 1개로 줄어듭니다.
rank(na_option="bottom")은 결측을 최상위로 올립니다. 적자를 걸러내지 않고 남겨둔 덕에 잡았습니다.- 시총 하한을 올릴수록 금융 편중이 심해집니다. 하한은 결과의 일부입니다.
- 2026년 9월 스냅샷으로 다시 돌리면 금융·지주 편중이 8개에서 4개로 줄어듭니다. 금융주의 PBR 중앙값이 0.38에서 0.48로 올랐기 때문입니다. 편중의 정도는 시점에 따라 달라지지만 방향은 같습니다.
이 글은 2024년 12월과 2026년 9월, 두 날의 스냅샷입니다. 2024년 12월에 뽑은 종목이 그 뒤 실제로 어떻게 됐는지, 그리고 매달 다시 뽑으면 어떻게 되는지는 다음 글의 주제인 워크포워드 검증에서 다룹니다. 그 글에는 krx_fetch_monthly.py로 받은 2024년 12월부터 2026년 8월까지의 월말 스냅샷 21개와 9월 18일 스냅샷을 씁니다. KRX 데이터 파일은 이 사이트에서 다시 배포하지 않으므로, 같은 결과를 보려면 KRX 계정으로 직접 받아야 합니다.
2026-09-28 수정: 지주회사 PBR이 구조적으로 낮은 이유를 “자산 대부분이 자회사 지분이라서”로 바로잡고, 금융·지주 PBR 중앙값 0.38과 나머지 하위 10% 0.37을 “같다”고 쓴 곳을 “거의 같다”로 고쳤으며, 시총 하한 표의 후보 수가 2026년 9월 기준이라는 점을 표 머리에 밝혔습니다.
2026-10-22 수정: 이름 규칙 때문에 일반으로 들어간 종목이 지주회사 GS 말고도 손해보험사 현대해상과 부동산신탁회사 한국자산신탁이 있어, 이 둘을 금융으로 치면 순위 평균 상위 20개 중 금융·지주가 8개가 아니라 10개라는 점을 “그룹 안에서 줄 세우기” 절에 덧붙였습니다.
이 글은 학습과 정보 공유 목적으로 작성되었으며, 특정 종목이나 상품에 대한 투자 권유가 아닙니다. 본문에 나오는 종목명은 공개 데이터의 정렬 결과일 뿐 추천이 아닙니다. 투자의 판단과 책임은 투자자 본인에게 있습니다.