논문 읽기 ④ — Harvey, Liu & Zhu (2016), 팩터 동물원과 t값 3이라는 기준
백테스트를 볼 때 던지는 질문 열 가지의 여덟 번째 질문은 “운만으로도 그만큼 나올 수 있는가”였습니다. 요일 효과 글에서는 열 번 비교한 것 가운데 가장 큰 t값 2.61을 그대로 믿기 어려웠고, 몬테카를로 검증 글에서는 무작위 포트폴리오 32개 중 1등만 골라도 성적이 크게 부풀었습니다. 한 사람이 여러 번 시도할 때 생기는 문제입니다.
Harvey, Liu & Zhu(2016)는 같은 문제를 학계 전체로 넓혀 봅니다. 많은 연구자가 비슷한 주식 데이터로 수백 개의 팩터를 시험해 왔고, 그중 t값 2를 넘은 것이 주로 논문으로 나왔다면 t값 2라는 기준은 얼마나 믿을 만한가 하는 질문입니다.
무엇을 했나
논문 제목은 말줄임표로 시작하는 “… and the Cross-Section of Expected Returns”입니다. “○○와 기대수익률의 횡단면”이라는 꼴의 논문이 워낙 많았다는 점을 빗댄 제목으로 읽힙니다. 이렇게 수백 개의 팩터가 쏟아진 상황을 흔히 ‘팩터 동물원(factor zoo)’이라고 부릅니다.
저자들은 새 팩터를 제안하고 검정한 논문 313편을 모아, 그 안에 나온 팩터 316개를 정리했습니다. 그리고 첫 실증 검정이 나온 1967년부터 시점마다, 그때까지 시험된 팩터 수를 반영하면 유의성 기준이 얼마여야 했는지 계산했습니다.
이 계산에 쓰는 도구가 다중검정 보정이고, 논문은 다음 세 가지 방법을 함께 봅니다.
- 본페로니: 검정을 N번 하면 유의수준을 N으로 나눕니다. 시험한 것 가운데 하나라도 잘못 통과할 확률을 5% 이하로 관리합니다.
- 홀름: 목표는 본페로니와 같지만 덜 엄격합니다. p값이 가장 작은 것부터 차례로 보면서 기준을 조금씩 느슨하게 합니다.
- BHY(Benjamini, Hochberg & Yekutieli): 목표가 다릅니다. 통과한 것 가운데 가짜가 차지하는 비율(거짓 발견 비율)을 관리합니다. 검정끼리 상관이 있어도 성립하도록 만든 방법입니다.
앞의 둘은 “하나도 틀리면 안 된다”에 가깝고, BHY는 “통과시킨 것 중 일부가 틀리는 것은 받아들이되 그 비율을 관리한다”에 가깝습니다.
무엇을 발견했나
결론은 초록에 그대로 나옵니다. 지금 새로 발견된 팩터라면 t값이 2가 아니라 3을 넘어야 한다는 것입니다. t값 3은 양쪽 p값으로 약 0.27%입니다. 시험된 팩터가 늘어날수록 기준도 올라가야 한다는 것이 논문의 뼈대이고, 저자들은 금융경제학에서 주장된 연구 결과의 대부분이 틀렸을 가능성이 높다고까지 말합니다.
작게 따라 해 보기
논문의 316개 팩터를 하나하나 다시 만들 수는 없어서, 세 가지를 작게 확인했습니다. 첫째, 수익이 전혀 없는 가짜 팩터로 시험을 많이 하면 무엇이 나오는지 봅니다. 둘째, 공개된 미국 팩터 몇 개가 논문 표본 뒤에도 기준을 넘었는지 봅니다. 셋째, 논문 읽기 ②의 25개 포트폴리오에 세 가지 보정을 적용합니다.
수익이 0인 팩터 316개
진짜 평균이 0인 월 수익률로 가짜 팩터 316개를 만들고, 각각의 월평균 수익률 t값을 구했습니다. 길이는 1963년 7월~2023년 12월과 같은 726개월이고, 이것을 2,000번 반복했습니다.
| 2,000번 반복한 결과 | |
|---|---|
| t값의 절댓값이 2를 넘는 가짜 팩터 | 평균 14.6개 (5~95% 범위 9~21개) |
| t값의 절댓값이 3을 넘는 가짜 팩터 | 평균 0.90개 |
| 절댓값 3을 넘는 것이 하나라도 나온 비율 | 59.5% |
| 316개 중 가장 큰 t값의 절댓값 | 중앙값 3.09 |
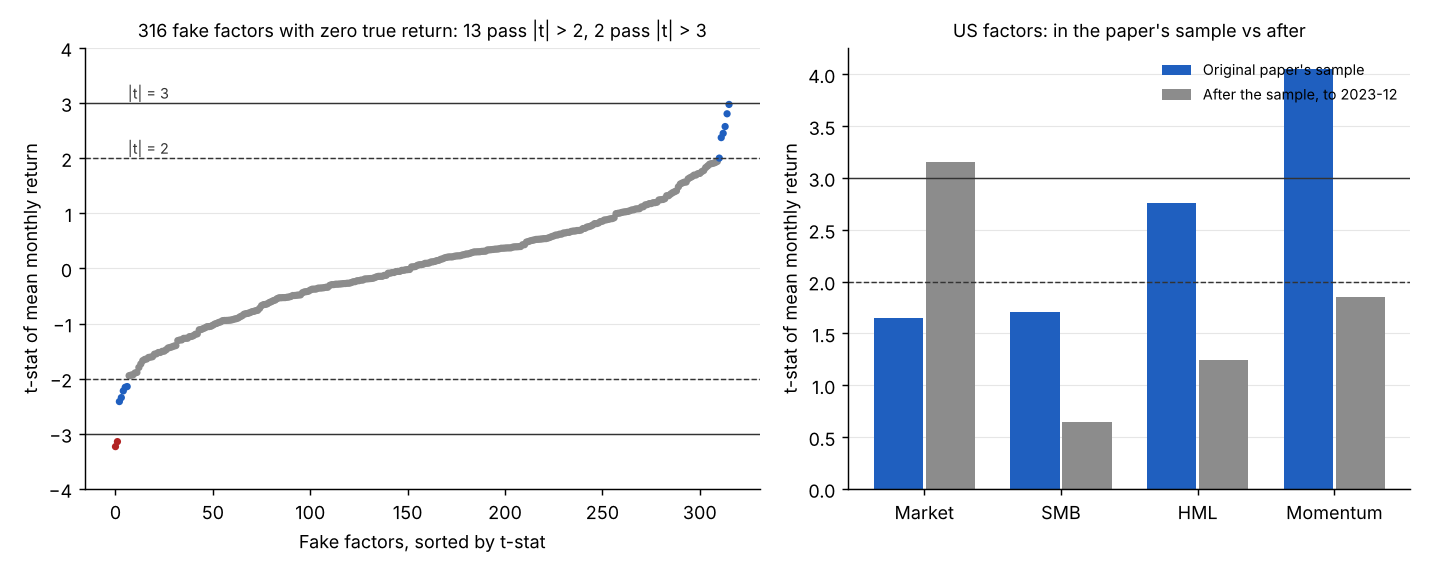
진짜 수익이 하나도 없어도 316개를 시험하면 15개 안팎에서 t값의 절댓값이 2를 넘습니다. 그중 하나만 논문으로 나왔다면 겉으로는 “t값 2.4의 새 팩터”처럼 보입니다. 기준을 3으로 올리면 평균 1개 미만으로 줄어듭니다. 그래도 316개 중 가장 큰 값의 중앙값이 3.09여서, 시험을 이만큼 하면 기준 3도 열 번 중 여섯 번은 가짜를 하나 이상 통과시킵니다. 아래 그림 왼쪽은 같은 방법으로 따로 한 번 만든 예로, 13개가 절댓값 2를, 2개가 절댓값 3을 넘었습니다.
그래서 본페로니처럼 검정 횟수를 기준에 넣는 방법을 씁니다. 양쪽 5% 기준으로 계산하면 다음과 같습니다.
| 검정 횟수 | 1 | 5 | 10 | 32 | 100 | 316 |
|---|---|---|---|---|---|---|
| 넘어야 할 t값 | 1.96 | 2.58 | 2.81 | 3.16 | 3.48 | 3.78 |
요일 효과 글의 화요일(t값 2.61)은 열 번 비교한 결과였으니 2.81을 넘어야 했고, 몬테카를로 글처럼 32개 중 1등을 골랐다면 3.16을 넘어야 했습니다. 논문이 제시한 3.0은 316번 시험한 본페로니 기준(3.78)보다 낮습니다. 위 실험처럼 서로 독립인 316번이라면 3.0으로도 열 번 중 여섯 번은 가짜가 하나 이상 통과하니, 3.0은 316번에 본페로니를 그대로 적용한 값이 아닙니다.
아래 코드는 위 두 표의 숫자를 그대로 다시 만듭니다. 데이터를 내려받지 않아서 바로 돌아갑니다.
import numpy as np
from statistics import NormalDist

T, N, SIMS = 726, 316, 2000            # 1963년 7월 ~ 2023년 12월의 개월 수, 가짜 팩터 수, 반복 횟수
rng = np.random.default_rng(7)
over2, over3, top = [], [], []
for _ in range(SIMS):
    r = rng.normal(0, 0.03, (T, N))    # 진짜 평균이 0인 월 수익률
    t = r.mean(0) / (r.std(0, ddof=1) / np.sqrt(T))
    over2.append((abs(t) > 2).sum())
    over3.append((abs(t) > 3).sum())
    top.append(abs(t).max())
print(f"절댓값 2 초과: 평균 {np.mean(over2):.1f}개 (5~95% {np.percentile(over2, 5):.0f}~{np.percentile(over2, 95):.0f}개)")
print(f"절댓값 3 초과: 평균 {np.mean(over3):.2f}개, 하나라도 나온 비율 {np.mean(np.array(over3) > 0):.1%}")
print(f"가장 큰 절댓값의 중앙값: {np.median(top):.2f}")

for n in [1, 5, 10, 32, 100, 316]:     # 검정을 n번 할 때의 본페로니 기준 (양쪽 5%)
    print(n, round(NormalDist().inv_cdf(1 - 0.05 / (2 * n)), 2))
실제 팩터는 논문 표본 뒤에도 기준을 넘었나
프렌치 교수 데이터 라이브러리의 공개 사본으로 미국 시장·SMB·HML·모멘텀 팩터의 월평균 수익률 t값을 논문 표본과 그 뒤로 나눠 구했습니다. 시장·SMB·HML은 Fama & French(1993)의 표본(1963년 7월~1991년 12월), 모멘텀은 Jegadeesh & Titman(1993)의 표본(1965~1989년)을 경계로 삼았습니다. “그 뒤”는 경계 다음 달부터 2023년 12월까지입니다.
| 팩터 | 논문 표본 월평균 | 논문 표본 t값 | 그 뒤 월평균 | 그 뒤 t값 |
|---|---|---|---|---|
| 시장 (무위험수익률을 뺀 초과수익) | 0.41% | 1.64 | 0.71% | 3.15 |
| SMB (소형주 - 대형주) | 0.27% | 1.71 | 0.11% | 0.64 |
| HML (가치주 - 성장주) | 0.38% | 2.76 | 0.21% | 1.25 |
| 모멘텀 (승자 - 패자) | 0.83% | 4.05 | 0.43% | 1.85 |
논문 표본에서 t값 3을 넘은 것은 모멘텀 하나였고, 그 모멘텀도 표본 뒤 34년 동안은 1.85로 2에도 못 미쳤습니다. HML은 표본 안에서 2는 넘었지만 3에는 못 미쳤고, 뒤에는 1.25였습니다. SMB·HML·모멘텀 모두 표본 뒤 월평균이 표본 안의 절반 안팎이나 그 아래로 줄었습니다. 표본 뒤 기간이 오히려 더 긴데도(시장·SMB·HML은 384개월 대 342개월, 모멘텀은 408개월 대 300개월) t값이 낮아졌습니다. 시장은 반대로 표본 뒤에 월평균이 커지면서 t값이 3을 넘었습니다.
이 비교는 두 논문이 실제로 보고한 검정과 같지 않습니다. Fama & French(1993)는 SMB와 HML의 평균이 0보다 크다는 것보다 이 팩터들이 수익률의 움직임을 설명한다는 데 무게를 둔 논문이고, 모멘텀 팩터는 Jegadeesh & Titman의 전략과 만드는 방법이 다릅니다. 논문이 발표된 뒤 수익이 줄어드는 현상은 따로 연구된 주제이기도 합니다(McLean & Pontiff, 2016). 표본 뒤에 줄어든 몫 가운데 얼마가 처음부터 운이었고 얼마가 발표 뒤 많은 사람이 따라 해서 줄어든 것인지는 이 숫자만으로 나눌 수 없습니다.
25개 포트폴리오에 세 가지 보정을 적용하면
논문 읽기 ②에서 쓴 규모 × B/M 25개 포트폴리오의 CAPM 절편을 1963년 7월~2023년 12월로 구하면, t값의 절댓값이 2를 넘는 것이 25개 중 11개입니다. 하나씩 보면 CAPM이 설명하지 못하는 포트폴리오가 11개인 셈입니다. 그런데 25번 검정했다는 점을 넣으면 숫자가 달라집니다.
| 기준 | 통과한 포트폴리오 |
|---|---|
| t값의 절댓값 2 | 11개 |
| t값의 절댓값 3 | 2개 |
| 본페로니 (25번, t값 3.09) | 2개 |
| 홀름 | 2개 |
| BHY (거짓 발견 비율 5%) | 0개 |
BHY가 0개인 것은 의외로 보일 수 있습니다. BHY는 p값이 k번째로 작은 후보에 5% × k / 25를 기준으로 쓰는데, 검정끼리 어떤 상관이 있어도 성립하도록 이것을 1 + 1/2 + … + 1/25(약 3.82)로 한 번 더 나눕니다. 그래서 1~3번째 후보에는 본페로니보다 엄격하고, 4번째부터 느슨해집니다. 기준을 넘는 후보 가운데 가장 뒤의 것까지를 모두 통과시키는데, 이번에는 어느 순위에서도 기준을 넘지 못했습니다. 첫째는 3.47을 넘어야 했는데 3.25였고, 가장 아깝게 모자란 둘째와 일곱째도 3.28에 3.22, 2.91에 2.86이었습니다.
그렇다고 CAPM이 25개 포트폴리오를 잘 설명한다는 뜻은 아닙니다. 25개 절편이 모두 0인지를 한 번에 묻는 GRS 검정은 처음부터 질문을 하나로 합치기 때문에 이 문제가 없고, 논문 읽기 ②에서 같은 기간의 GRS 검정은 CAPM을 분명하게 기각했습니다(p값 0.0001 미만). 여러 개를 따로 시험할 때는 보정이 필요하고, 질문 자체를 하나로 합칠 수 있으면 그렇게 하는 편이 낫습니다.
읽으면서 든 의문들
몇 번 시험했는지 알 수 있나. 논문으로 나온 316개는 셀 수 있지만, 시험했다가 발표하지 않은 것은 알 길이 없습니다. 실제 검정 횟수는 이보다 많을 가능성이 큽니다. 반대로 서로 비슷한 팩터가 많아서 사실상 독립인 시험은 316번보다 적을 수도 있습니다. 본페로니는 검정끼리 상관이 있을 때 필요 이상으로 엄격해지기 쉽습니다. 기준 3을 이 두 방향 사이의 타협으로 읽을 수도 있지만, 어느 쪽이 더 큰지는 알 수 없습니다.
기준을 올리면 놓치는 것은 없나. 기준 3은 가짜가 통과하는 경우를 줄이는 대신, 진짜 효과가 있는데도 놓치는 경우를 늘립니다. 반론도 있습니다. Jensen, Kelly & Pedersen(2023)은 베이지안 방법으로 보면 대부분의 팩터가 재현되고, 관찰된 팩터가 많다는 사실이 오히려 증거를 강하게 만든다고 주장했습니다.
개인 백테스트에는 어떻게 쓰나. 몇 가지를 시도했는지 모르면 2.81을 써야 할지 3.16을 써야 할지도 정할 수 없습니다. 시도한 설정의 개수를 결과와 함께 적어 두는 것이 기준을 올리는 것보다 먼저입니다.
정리하면
- 시험을 많이 하면 진짜 수익이 없어도 t값의 절댓값이 2를 넘는 결과가 나옵니다. 수익이 0인 가짜 팩터 316개 중 평균 14.6개가 그랬습니다.
- 논문은 새 팩터라면 t값 3을 넘어야 한다고 제안했습니다. 검정 횟수를 기준에 넣어야 한다는 생각을 숫자 하나로 줄인 것입니다.
- 살펴본 미국 팩터 네 개(시장·SMB·HML·모멘텀) 가운데 논문 표본에서 3을 넘은 것은 모멘텀뿐이었고, 그 모멘텀도 표본 뒤 34년 동안은 1.85였습니다.
- 여러 개를 따로 시험했다면 보정하고, 질문을 하나로 합칠 수 있다면 합칩니다. 어느 쪽이든 몇 번 시험했는지를 알아야 합니다.
데이터와 한계
- 팩터와 포트폴리오 수익률은 프렌치 교수 데이터 라이브러리의 월별 자료를 공개 저장소에 옮겨 둔 사본에서 가져왔습니다. 3팩터와 25개 포트폴리오(시가총액 가중)는 2023년 12월에 끝나고, 모멘텀은 2024년 2월까지 있지만 2023년 12월까지만 썼습니다.
- 팩터와 가짜 팩터의 t값은 월평균 수익률을 (월 수익률 표준편차 / 개월 수의 제곱근)으로 나눈 값이고, 25개 포트폴리오의 절편 t값은 보통의 회귀분석 표준오차로 구했습니다. 어느 쪽도 수익률의 자기상관은 보정하지 않았고, p값은 개월 수가 많아 정규분포로 근사했습니다.
- 가짜 팩터는 서로 독립인 정규분포 난수입니다. 실제 팩터는 서로 상관이 있고 꼬리가 두꺼워서, 실제 검정 316번의 결과는 이와 다를 수 있습니다.
- 논문의 316개 팩터 목록과 각 팩터의 t값, 시점별 기준의 변화 같은 본문 수치는 옮기지 않았습니다. 논문에서 가져온 것은 팩터 수, 보정 방법, 기준 3.0 같은 핵심 결론입니다.
- 표, 그림, 25개 포트폴리오의 보정 결과를 만든 전체 코드는 factor_hurdle.py에 있습니다.
참고 자료
- Harvey, C. R., Liu, Y., & Zhu, H. (2016). … and the Cross-Section of Expected Returns. Review of Financial Studies, 29(1), 5–68.
- Holm, S. (1979). A Simple Sequentially Rejective Multiple Test Procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Benjamini, Y., & Yekutieli, D. (2001). The Control of the False Discovery Rate in Multiple Testing under Dependency. Annals of Statistics, 29(4), 1165–1188.
- McLean, R. D., & Pontiff, J. (2016). Does Academic Research Destroy Stock Return Predictability? Journal of Finance, 71(1), 5–32.
- Jensen, T. I., Kelly, B., & Pedersen, L. H. (2023). Is There a Replication Crisis in Finance? Journal of Finance, 78(5), 2465–2518.
이 글은 학습과 정보 공유 목적으로 작성되었으며, 특정 종목이나 상품에 대한 투자 권유가 아닙니다. 과거 데이터로 계산한 결과는 미래 성과를 보장하지 않습니다. 투자의 판단과 책임은 투자자 본인에게 있습니다.